열린강의실
AI for Quantum: 양자의 다음 도약, 학습에서 길을 찾다
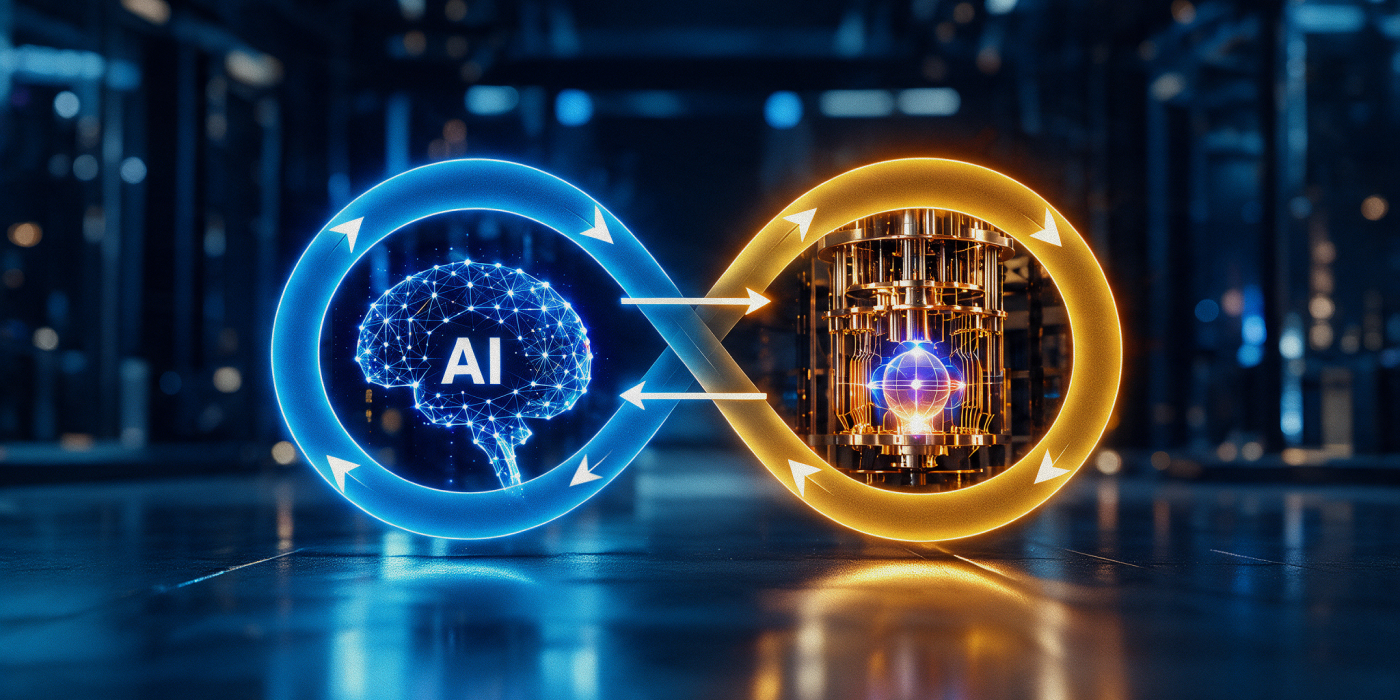
※ 본 이미지는 챗GPT(으)로 제작되었으며 퀀텀웨이브에서 가공하였습니다.
KEY SUMMARY
양자기술의 가능성을 실제 성능으로 연결하기 위해서는 양자상태를 견고하게 만들고, 필요한 정보를 정교하게 읽어내며, 변화하는 환경에서도 장치를 안정적으로 작동시켜야 한다. 그러나 양자계의 규모와 복잡성이 커질수록 이러한 과정을 연구자의 직관과 수작업에만 맡기기는 어려워진다. AI for Quantum은 바로 이 지점에서 출발한다. 측정과 실험에서 얻은 정보를 학습하고, 그 결과를 다음 설계와 제어에 반영함으로써 양자정보과학의 오랜 병목을 풀어가고자 하는 접근이다.
2010년 전후의 초기 연구는 양자 측정의 피드백 규칙과 양자알고리즘의 핵심 모듈을 학습할 수 있는지 물었다. 이후 학습의 대상은 새로운 실험의 설계, 복잡한 양자상태의 표현과 재구성, 양자통신망의 운용, 센서의 신호 추정으로 넓어졌다. 최근에는 실시간 피드백과 양자오류정정에 AI가 적극 참여하면서, 좋은 설정을 한 번 찾는 단계를 넘어 장치가 작동하는 동안 성능을 유지하고 실시간으로 개선하는 방향으로 연구가 발전하고 있다. 이 과정은 AI가 양자 연구의 분석 도구에서 설계와 운용의 일부로 자리 잡아온 역사이기도 하다.
이 흐름은 양자머신러닝(Quantum Machine Learning, QML)을 이해하는 시야도 넓힌다. 고전 AI가 양자정보처리를 돕고, 양자 작업에서 얻은 데이터와 물리적 제약이 다시 학습의 목표와 방법을 바꾼다. QML의 전반적인 프레임워크에서 보자면, 이는 양자 자원의 이점이 학습의 효율 향상으로 자연스럽게 연결되는 것도 가능케한다. 이러한 상호작용을 발전시키는 QML은 양자컴퓨팅의 활용·응용사례를 발굴하고 연구개발 과정을 고도화할 매우 중요한 분야다. 양자기술의 확보와 함께, 그 기술을 어떻게 학습하고 활용할 것인지에 대한 연구역량을 축적해야 할 시점이 바로 지금이다.
양자기술의 가능성 및 그것의 활용 사이
양자기술의 역사는 새로운 계산 및 정보처리의 가능성을 발견해온 역사다. 중첩과 얽힘 등의 양자성은 기존 컴퓨터와 다른 계산 방식을 열었고, 양자이론에 기반한 측정 특성은 통신의 보안성과 센서의 정밀도를 높일 수 있는 기반을 제공했다. 이러한 가능성은 양자정보과학을 성장시킨 강력한 동력이었다. 다만 물리 법칙이 허용하는 가능성과 실제 장치에서 얻을 수 있는 성능 사이에는 상당한 거리가 있었다.
양자컴퓨터를 예로 들면, 큐비트를 만드는 일과 유용한 알고리즘을 실행하는 일 사이에는 수많은 설계 문제가 놓여 있다. 어떤 회로가 필요한지, 그 회로를 장치가 허용하는 연산으로 어떻게 구현할지, 제어 신호를 어떻게 조절할지, 측정 결과에 섞인 오류를 어떻게 해석할지를 결정해야 한다. 양자통신과 양자센싱도 마찬가지다. 좋은 양자상태를 준비하는 능력만으로는 충분하지 않다. 손실과 잡음 속에서 그 상태의 이점을 실제 사용자가 접근 가능한 정보 형태로 바꾸는 방법이 필요하다.
따라서, 새로운 알고리즘과 실험을 찾아내는 일, 커지는 양자계를 검증하는 일, 복잡한 장치를 안정적으로 운용하는 일에서는 기존 방법의 부담이 점차 뚜렷해졌다. 이에, 대략 2010년 초반 본격적으로 시작된 초창기 AI와 양자정보과학 분야의 융합은, 연구자가 모든 변수를 찾아내 최적의 해법을 직접 구성하는 방식으로는 탐색할 수 있는 범위에 한계가 있었다는 사실을 이해하고 받아들이는 것부터 시작되었다.
비슷한 시기 AI에서는 데이터를 통해 복잡한 관계를 표현하고, 행동 전략을 개선하는 방법이 급속도로 발전했다. 특히, 딥러닝의 시작과 AI 모델의 고도화가 한창이던 이 시점에, 양자정보 연구자들은 새로운 질문을 가졌다. 결과에 도달하는 모든 단계를 꼭 모두 알아야 할까? 사용할 수 있는 자원과 결과를 평가할 기준을 주고 해결 방법을 스스로 학습하게 할 수는 없을까? 양자정보와 기계학습의 만남은 이 질문을 구체적인 연구주제로 바꾸었다.
QML은 흔히 양자컴퓨터를 이용해 기계학습을 가속하는 연구로 소개된다. 그러나 양자정보와 학습의 접점에는 데이터를 이해하고, 양자 실험을 설계하며, 양자장치를 제어하는 연구도 놓여 있다[1]. 이 글에서는 이러한 상호작용을 포괄하는 넓은 의미의 QML을 바탕으로, AI가 양자 연구의 문제를 푸는 방식을 어떻게 바꾸어왔는지 살펴본다.
측정법에서 알고리즘까지, 해법을 학습하다
양자 측정은 학습의 가치를 일찍 확인할 수 있었던 영역이다. 측정 결과는 확률적으로 나타나며, 한 번의 관측만으로 원하는 물리량을 정확하게 알 수 없는 경우가 많다. 따라서 이전 결과를 보고 다음 측정 조건을 조절하는 적응적 전략이 중요하다[2]. 문제는 가능한 관측 기록이 늘어날수록 각 상황에 무엇을 해야할지 미리 설계하기가 어려워진다는 점이다.
Hentschel과 Sanders는 2010년 기계학습을 이용해 양자 측정의 적응적 피드백 전략을 찾는 연구를 발표했다[3]. 간섭계에서 위상을 추정하는 문제에 입자군 최적화 방법을 적용해, 측정 결과에 따라 제어 조건을 바꾸는 규칙을 탐색했다. 그 결과 연구에서 비교한 기존의 우수한 적응 측정법보다 좋은 성능을 내는 전략을 얻었다. 양자 측정의 성능을 좌우하는 의사결정 규칙 자체를 학습의 대상으로 삼을 수 있음을 보여준 초기 사례였다.
이 관점은 양자알고리즘의 설계로 이어졌다. Bang 등은 2014년 “양자 학생(quantum student)”과 “고전 교사(classical teature)”가 상호작용하는 학습 프레임워크를 제안했다[4]. 양자 학생이 조절 가능한 양자 변환을 실행하고 측정 결과를 내놓으면, 고전 교사가 그 결과를 평가해 변환의 매개변수를 갱신하는 구조다. 정답 회로를 직접 입력하는 대신, 주어진 문제를 해결하는 데 필요한 양자알고리즘의 핵심 모듈을 스스로 학습하도록 했다. 이 연구는 양자 모듈을 학습으로 찾는 일과 학습 자체의 효율을 연결했다는 점에서도 의미가 있다. 양자 해법이 더 적은 질의 단계로 구현될 때 학습이 탐색해야 할 단계 역시 줄어들 수 있도록 구성한 것이다. 연구진은 Deutsch–Jozsa 문제에서 단일 질의 해법을 이루는 양자 변환을 학습하고, 수치 실험을 통해 학습 효율의 유리한 스케일링을 확인했다. 이는 양자알고리즘 개발을 학습 문제로 바꾸는 단초를 제공하면서, 양자 작업의 효율성이 학습 과정의 이점으로 이어질 수 있음을 탐구한 초창기 연구였다.
두 연구에서 눈여겨볼 변화는 학습의 대상이다. 측정값을 분류하거나 얻은 데이터를 정리하는 데서 더 나아가, 어떤 측정을 수행하고 어떤 양자 변환을 구성해야 하는지를 배우기 시작했다. 사람이 목표를 정하고 학습이 그 목표에 도달하는 절차를 스스로 찾는 방식이 등장한 것이다. 또한 이때부터 이미 고전적인 학습 과정과 양자 작업은 하나의 피드백 구조 안에 들어와 있었다. 오늘날 AI for Quantum과 Quantum for AI의 접점에서 논의되는 문제의식이 이미 이 시기에 모습을 드러냈다.
연구자의 직관을 확장하는 실험 설계
양자알고리즘의 핵심 모듈을 학습할 수 있다면, 실험 장치의 구성도 학습하거나 탐색할 수 있을까? 양자광학 실험에서는 광원, 빔분할기, 위상 조절기, 검출기 등을 어떻게 배치하는지에 따라 만들 수 있는 상태가 달라진다. 부품이나 재료가 조금만 늘어나도 가능한 조합은 급격히 증가한다. 연구자의 경험은 탐색 방향을 정하는 데 큰 도움이 되지만, 익숙한 구성을 중심으로 생각하게 만드는 제약이 되기도 한다.
Krenn 등이 2016년 발표한 MELVIN은 이러한 설계 공간을 컴퓨터로 탐색한 대표적인 연구다[5]. 사용할 수 있는 광학 부품을 조합하고, 그 구성에서 생성되는 양자상태를 평가해 목표에 맞는 실험을 찾았다. 유용한 구성은 다시 사용할 수 있는 요소로 축적했다. 이 과정에서 사람에게 직관적이지 않은 비대칭적인 배치와 고차원 얽힘을 만드는 설계가 등장했다. 복잡한 양자 실험을 제안하는 과정 자체가 자동화의 대상이 될 수 있음을 보여준 것이다.
이어 Melnikov 등은 2018년 강화학습을 이용해 실험 설계의 경험을 축적하는 방법을 제시했다[6]. 학습 에이전트는 가상의 광학 실험 환경에서 부품을 선택하고, 만들어진 상태가 목표를 만족하는지에 따라 보상을 받았다. 반복되는 탐색 속에서 유용한 부분 구성을 익히고 이를 다른 설계에도 활용했다. 개별 해답을 찾는 것과 함께, 다음 문제를 더 잘 풀기 위한 설계 전략이 학습되기 시작했다는 점이 핵심이다.
이러한 접근들은 실제 실험으로도 이어졌다. Erhard 등이 2018년 구현한 세 광자의 고차원 GHZ 얽힘 실험은 MELVIN이 제시한 설계에서 영감을 얻었다[7]. 자동 탐색이 새로운 후보를 제안하고, 연구자가 그 원리를 이해하며, 실제 장치의 제약에 맞추어 구현하는 협력이 이루어진 것이다. 학습과 탐색의 결과가 연구자의 물리적 해석을 거쳐 실험적 성과로 연결될 수 있음을 보여주는 사례였다.
이 단계에서 AI의 가치는 연구자가 검토할 수 있는 가능성을 넓히는 데 있었다. 낯선 실험 배치는 왜 작동하는지 설명해야 할 새로운 질문을 만든다. 그 질문을 이해하는 과정에서 재사용할 수 있는 실험 기법이나 설계 원리가 드러날 수 있다. AI가 내놓은 해답의 성능을 확인하는 것과 그 해답을 이해하는 일이 함께 진행될 때, 자동화는 과학적 발견의 과정에 더 깊이 참여하게 된다.
거대한 양자상태를 다루는 새로운 언어
실험 설계의 가능성이 넓어지면, 그 실험이 만들어낸 상태를 어떻게 표현하고 평가할 것인지가 중요해진다. 일반적인 𝑁 큐비트 순수상태를 그대로 기술하려면 2𝑁개의 복소수 계수가 필요하다. 큐비트 수가 늘어날수록 상태를 저장하고 계산하는 부담은 빠르게 커진다. 양자상태를 재구성하는 일 역시 필요한 측정의 종류와 양이 증가하면서 어려워진다.
실험 설계의 자동화가 주목받던 시기, 기계학습은 이러한 표현의 문제에도 새로운 길을 제시했다. Carleo와 Troyer는 2017년 인공신경망으로 양자 다체 파동함수를 표현하는 방법을 발표했다[8]. 가능한 상태의 계수를 모두 개별적으로 저장하는 대신, 신경망의 매개변수가 상태의 구조를 담도록 했다. 연구진은 이 표현을 이용해 여러 스핀 모형의 바닥상태와 시간에 따른 변화를 계산할 수 있음을 보였다. 이후 “신경망 양자상태(neural quantum state, NQS)”로 불리는 연구 흐름을 연 중요한 결과였다.
Torlai 등은 2018년 이 관점을 양자상태 토모그래피로 확장했다[9]. 토모그래피는 여러 조건에서 얻은 측정 결과를 바탕으로 양자상태를 재구성하는 과정이다. 연구진은 측정 데이터에 나타난 상관관계를 신경망이 학습하도록 해, 연구에서 다룬 다체 양자상태를 효율적으로 복원했다. 양자상태의 표현을 학습하는 접근이 이론적 계산뿐 아니라 실험에서 얻은 정보를 해석하는 문제에도 적용될 수 있음을 보여주었다.
여기서 핵심은 물리적으로 관심 있는 상태에 존재하는 구조를 활용한다는 점이다. 모든 가능한 양자상태가 작은 신경망으로 정확하게 표현되는 것은 아니다. 그러나 실제 연구에서 다루는 상태에는 상호작용의 형태, 대칭성, 공간적 상관관계 등 이용할 수 있는 특징이 존재한다. 학습 모델은 이러한 규칙성을 포착함으로써 필요한 계산이나 측정의 부담을 줄일 수 있다. 표현의 성공 여부도 대상 상태와 알고자 하는 물리량에 따라 평가해야 한다.
이 변화는 QML의 연구 질문을 한층 넓혔다. 어떤 행동을 선택할 것인지에 더해, 복잡한 양자계를 어떤 표현으로 이해할 것인지가 학습의 문제가 되었다. 실험 설계가 가능한 해법의 범위를 넓혔다면, 학습된 표현은 그 해법을 평가하고 비교할 수 있는 수단을 제공했다. 설계와 분석이 연결되면서 더 큰 양자계를 다루기 위한 연구의 기반이 확장된 셈이다.
변화하는 환경에서 통신하고 측정하다
좋은 실험과 좋은 상태 표현을 확보해도 장치의 성능이 항상 유지되는 것은 아니다. 실제 환경에서는 온도와 진동이 변하고, 광학계의 위상이 흔들리며, 검출기의 응답도 달라진다. 통신망의 각 구간은 서로 다른 손실과 잡음을 갖는다. 실험실에서 찾은 최적의 조건을 현장에서 유지하려면 관측된 변화를 해석하고 다음 동작을 조정하는 능력이 필요하다. 2010년대 후반에는 이 문제가 AI for Quantum의 중요한 무대로 떠올랐다.
양자통신에서 이러한 변화는 운용 효율의 문제로 나타났다. Liu 등은 2019년 양자키분배 장치의 위상 변조 조건이 시간에 따라 달라지는 현상을 학습하고 예측했다[10]. 시계열 학습에 사용되는 LSTM 신경망을 이용해 장치의 변화를 미리 보정함으로써, 반복적인 점검과 교정에 필요한 시간을 줄였다. 10일 이상 진행한 실험에서 기존 방식과 비슷한 양자비트 오류율을 유지하면서 키 전송의 운용 효율을 높였다. 양자통신의 실제 성능에는 전송이 가능한 시간 자체도 중요하다는 점을 드러낸 연구다.
네트워크 규모에서는 의사결정이 더 복잡해진다. 먼 거리까지 얽힘을 연결하려면 중간 구간에서 만들어진 자원을 언제 결합하고, 품질을 높이기 위한 연산을 어디에 배치할지 결정해야 한다. Wallnöfer 등은 2020년 강화학습으로 양자통신 프로토콜과 중계 전략을 탐색했다[11]. 이론적/수치적 환경에서 기존의 주요 프로토콜을 재발견하고, 구간별 조건이 다른 상황에 맞는 전략을 찾았다. 학습의 대상이 개별 장치의 조절값에서 여러 양자 작업을 배치하는 운용 정책으로 넓어진 것이다.
양자센싱에서는 제한된 측정 자원으로 필요한 정보를 얼마나 빠르게 얻을 수 있는지가 중심 문제였다. Santagati 등은 2019년 다이아몬드의 단일 전자스핀을 이용한 자기장 측정에 베이지안 학습을 적용했다[12]. 잡음이 큰 상온의 광학 판독 결과를 바탕으로 자기장에 대한 추정을 갱신하고, 다음 측정 조건을 선택했다. 각 단계에서 얻을 수 있는 신호가 약하더라도, 측정 기록을 누적해 불확실성을 줄이는 전략이 유용한 센싱 성능으로 이어질 수 있음을 보여주었다. 2021년 Lee 등은 단일측정학습(Single-shot measurement learning, SSML) 알고리즘을 개발하여, 상태학습에의 세계최고 수준의 정확도를 보였다[2]. 이는 사용장비 자체의 결함을 알고리즘 및 소프트웨어의 고도화를 통해 극복할 수 있음을 최초로 보인 연구라는 점에서 주목받았다.
이 연구들은 사용하는 학습법도, 다루는 장치도 다르다. 그러나 이미 확보한 정보로 다음 행동을 더 잘 선택한다는 공통점을 갖는다. 통신에서는 교정 시간을 줄이고 얽힘 자원을 효율적으로 사용하며, 센싱에서는 정보가 풍부한 측정을 선택한다. QML의 실질적인 성과는 이처럼 장치의 구체적인 병목과 학습의 목표가 맞닿는 곳에서 나타나기 시작했다.
양자장치의 시간에 맞춰 움직이는 AI
장치를 운용하는 데 AI를 활용하려면 정확도와 함께 반응 시간도 고려해야 한다. 양자상태는 환경과 상호작용하며 변하고, 필요한 조치를 늦게 적용하면 정보가 이미 손상될 수 있다. 분석 결과를 얻은 뒤 다음 실험을 준비하는 상황과, 현재 진행 중인 양자 동작에 즉시 개입하는 상황은 서로 다른 요구를 갖는다. AI가 양자장치의 제어 과정에 들어가려면 학습된 판단을 장치의 시간 척도 안에서 실행할 수 있어야 한다.
Reuer 등은 2023년 이러한 요구에 대응하는 실험을 보고했다[13]. 연구진은 강화학습으로 훈련한 신경망을 FPGA에 구현해, 측정 결과에 따라 초전도 큐비트의 다음 동작을 결정하도록 했다. 학습은 실제 측정 데이터를 바탕으로 이루어졌고, 학습된 신경망은 마이크로초보다 짧은 지연으로 작동했다. 단일 큐비트의 초기화라는 구체적인 과제에서, 학습 기반 판단을 실시간 양자 피드백에 사용할 수 있음을 보여주었다.
양자오류정정은 또 다른 매우 중요한 과제를 제시하였다. 여러 물리 큐비트에 정보를 분산해 저장하고 반복적으로 오류의 징후를 측정하더라도, 그 기록만으로 실제 어떤 오류가 발생했는지 바로 알 수 있는 것은 아니다. 여러 가능성 가운데 가장 그럴듯한 오류를 추론해야 한다. 이 과정을 디코딩이라고 한다. 장치가 커지고 오류가 시간과 공간에 걸쳐 상관관계를 보일수록, 측정 기록을 해석하는 문제도 복잡해진다. Bausch 등이 2024년 발표한 AlphaQubit은 이 추론에 학습을 적용했다[14]. 반복되는 오류 측정 기록을 처리하도록 설계한 신경망을 모의 데이터로 훈련하고 실제 프로세서의 데이터에 맞추어 조정했다. 연구에서 비교한 디코더들보다 높은 정확도를 보였으며, 실제 장치에 존재하는 복잡한 오류의 특징을 학습하는 접근의 가치를 입증했다. 이 성과는 실험 기록을 이용한 디코딩 정확도의 개선이며, 실제 오류정정의 속도 요구를 만족하는 실시간 구현은 별도의 과제로 남았다.
Reuer의 연구와 AlphaQubit을 함께 보면 AI for Quantum의 과제가 선명해진다. 빠른 판단과 정확한 추론을 양자장치가 요구하는 조건에서 함께 실현해야 한다. 이를 위해서는 어떤 데이터를 입력할지, 과거 기록을 얼마나 기억할지, 신경망을 어디에서 실행할지까지 고려해야 한다. 학습 모델의 설계와 양자장치의 설계가 점점 가까워지는 이유다.
더 적은 자원으로, 더 오래 작동하는 시스템
양자정보처리의 규모가 커질수록 개별 요소의 성능만으로 전체 시스템을 평가하기 어려워진다. 회로에서 특정 연산을 줄이면 실행에 필요한 자원이 달라지고, 센서의 상태를 유지하는 방법이 바뀌면 얻을 수 있는 정보의 양이 달라진다. 오류를 해석하는 능력과 오류 발생을 줄이는 제어 역시 서로 영향을 준다. 최근 연구는 이러한 연결을 활용해 시스템 전체의 효율과 지속성을 높이는 방향으로 나아가고 있다.
회로 설계에서는 Ruiz 등이 2025년 발표한 AlphaTensor-Quantum이 이러한 방향을 보여준다[15]. 연구진은 양자회로의 최적화를 텐서 분해 문제와 연결하고 강화학습으로 해법을 찾았다. 여러 산술 회로에서 오류정정 양자컴퓨팅의 자원 부담을 크게 좌우하는 T 게이트의 수를 줄였다. 알고리즘을 실제 장치에서 실행하는 데 필요한 비용을 학습으로 낮출 수 있다는 사례다. 새로운 알고리즘을 찾는 일과 알려진 알고리즘을 더 효율적으로 구현하는 일 모두가 학습의 대상이 되고 있다.
양자센싱에서는 Duan 등이 2025년 스핀 압축 상태의 유지와 시간에 따라 변하는 자기장의 추적을 결합했다[16]. 스핀 압축은 측정에 중요한 방향의 양자적 불확실성을 줄이는 방법이다. 연구진은 원자 집단에서 이러한 상태를 지속적으로 유지하면서, 광학 측정 기록에 담긴 변화를 딥러닝 모델로 해석했다. 스핀 압축을 억제한 경우와의 비교를 통해 양자 자원이 제공하는 성능 향상도 확인했다. 양자적으로 유리한 상태를 만드는 능력과 그 상태에서 유용한 정보를 읽어내는 학습이 하나의 센싱 과정 안에서 결합한 것이다.
2026년 Sivak 등의 연구는 지속적인 적응을 양자오류정정의 운용으로 확장했다[17]. 오류정정 과정에서 얻은 오류 검출 신호를 강화학습의 피드백으로도 사용해, 환경 변화에 맞추어 제어 매개변수를 조정했다. Willow 초전도 프로세서의 양자 메모리 실험에서 천 개가 넘는 제어 변수를 다루었고, 인위적으로 가한 드리프트에 대한 논리적 안정성을 개선했다. 계산을 수행하는 동안 생기는 정보가 장치를 더 잘 운용하기 위한 학습 자료가 되는 구조다. 이러한 연구에서 중요한 것은 “최적화가 언제 끝나는가”에 대한 관점의 변화다. 실제 장치는 계속 변하므로 한 번 찾은 좋은 설정도 시간이 지나면 다시 조정해야 한다. 양자상태의 준비와 측정, 결과의 해석, 장치의 제어를 반복적으로 연결하는 능력이 필요하다. AI의 역할도 초기 설정을 도와주는 단계에서, 양자정보처리 과정이 성능을 유지하도록 지속적으로 참여하는 방향으로 확장되고 있다.
AI와 양자를 구분하는 선을 넘어
“AI for Quantum” 그리고 “Quantum for AI” 라는 구분은 연구의 출발점을 설명하는 데 유용했다. 어떤 연구는 고전 AI로 양자장치의 성능을 높이는 데서 시작하고, 다른 연구는 양자정보처리로 학습의 효율을 높이는 데서 시작한다. 다만 실제 연구가 구체화되면 고전 계산, 양자 작업, 측정, 학습이 하나의 절차 안에서 여러 차례 연결된다. 각각의 성능은 다른 부분을 어떻게 구성하느냐에 따라 달라진다.
앞서 살펴본 연구들에서는 양자 문제의 특성이 AI의 사용 방법을 바꾸었다. 실시간 피드백에서는 측정 데이터가 들어오는 동안 계산을 진행할 수 있는 신경망 구조가 필요했다. 오류 디코딩에서는 반복 측정 기록의 관계를 학습해야 했다. 지속적인 장치 제어에서는 드물게 발생하는 논리 오류를 기다리기보다, 더 자주 얻을 수 있는 오류 검출 신호를 학습 목표로 활용했다. 양자정보처리의 요구가 입력 표현, 학습 목표, 추론 방식의 설계로 이어진 것이다[13,14,17]. 이는 기존 AI 기술을 양자 분야에 적용하는 일 자체가 새로운 방법론을 만드는 과정이 될 수 있음을 뜻한다. 양자계는 내부 상태를 원하는 대로 관찰하기 어렵고, 측정은 상태에 영향을 주며, 실험 데이터에는 시간과 장치 사용 비용이 든다. 이런 조건에서는 적은 관측으로 배우는 방법, 물리적 제약을 반영하는 표현, 변화하는 환경에 적응하는 학습이 중요해진다. 그 과정에서 얻은 방법은 다른 과학 실험과 제어 문제를 다루는 데에도 참고할 수 있다.
양자 자원이 학습에 주는 이점도 이러한 전체 구조 안에서 살펴볼 필요가 있다. Huang 등은 2022년 특정한 양자 실험 학습 과제에서, 양자 데이터를 양자 메모리에 저장하고 처리하는 방식이 필요한 실험 횟수를 크게 줄일 수 있음을 이론과 실험으로 제시했다[18]. 이 결과는 양자 데이터를 어떤 단계에서 측정하고, 어떤 형태로 보존하며, 어떻게 학습에 전달하는지가 자원 효율을 바꿀 수 있음을 보여준다. 이점이 성립하는 과제와 접근 조건을 명시하는 것이 핵심이다.
Bang 등의 초기 연구에서 제기된 연결도 이 맥락에서 다시 읽을 수 있다. 학습은 양자 모듈을 구성하고, 구성된 모듈의 특성은 다시 학습의 효율에 영향을 줄 수 있다. 물론 고전 AI와 양자장치를 결합했다는 사실만으로 양자속도향상이 저절로 보장되지는 않는다. 그러나 두 방향을 함께 연구하면 어느 부분에서 고전 학습이 효과적이고, 어느 부분에서 양자 자원이 필요하며, 둘의 상호작용을 어떻게 설계해야 하는지를 더 구체적으로 물을 수 있다. 현재 QML의 발전을 이끄는 질문도 이러한 전체 프레임워크로 확장되고 있다.
활용과 응용을 통한 R&D 방법론의 고도화
이러한 관점에서 QML은 양자컴퓨팅의 활용·응용사례를 발굴하는 중요한 연구 분야가 될 것이다. 새로운 응용을 찾으려면 현실의 문제를 계산 가능한 형태로 바꾸고, 양자 작업에 적합한 부분을 골라내며, 제한된 장치 자원 안에서 실행할 방법을 찾아야 한다. 학습은 이 과정의 여러 단계에 참여할 수 있다. 후보 회로를 탐색하고, 측정할 대상을 선택하며, 잡음 속에서 필요한 정보를 추출하는 일이 모두 응용의 성패와 연결된다. 예를 들어, 양자 시뮬레이션을 활용하는 연구에서는 어떤 상태를 준비할지, 어떤 관측량을 측정할지, 다음 실험을 어디에 집중할지가 중요한 선택이 된다. 학습 모델이 유망한 후보를 제안하고, 양자 실험이 정보를 제공하며, 그 결과로 모델을 갱신하는 연구 절차를 생각할 수 있다. 이러한 구조가 실제 이점을 제공하는지는 대상 문제와 자원 조건에 따라 검증해야 한다. 그 검증 과정 자체가 양자컴퓨팅의 유효한 활용 범위를 구체화하는 작업이다.
이러한 연구 방향은 Klimesch 등이 2026년 Nature 논문을 통해 체계적으로 정리하였다[19]. 연구진은 양자광학을 비롯한 물리실험의 AI 기반 설계를 종합하면서, 가능한 장치 구성을 담는 탐색 공간, 빠르고 신뢰할 수 있는 시뮬레이터, 과학적 목표를 반영하는 평가 기준, 그리고 효율적인 탐색 알고리즘 개발/활용을 핵심 요소로 제시했다. 이는 AI의 역할이 주어진 장치의 매개변수를 조정하는 수준에서 새로운 실험 구조와 개념을 제안하는 단계로 확장되고 있음을 보여준다. 이러한 관점은 QML 역시 학습 알고리즘과 물리적 구현, 성능 평가를 함께 설계함으로써 양자기술의 새로운 활용 가능성을 발굴하는 R&D 방법론으로 발전할 수 있음을 시사한다.
응용 연구는 하드웨어 개발에도 정보를 제공할 수 있다. 알고리즘이 자주 사용하는 연산, 필요한 측정 정확도, 허용할 수 있는 지연과 오류를 알아야 장치의 개발 목표를 더 구체적으로 설정할 수 있다. 특정 제어 기능이 추가되었을 때 응용 성능이 얼마나 좋아지는지도 평가할 수 있다. QML을 통한 활용 연구는 이처럼 알고리즘과 장치의 요구를 서로 연결하면서 연구개발의 방향을 정교하게 만드는 역할을 할 것이다.
학습 결과물을 평가하는 기준도 이에 맞추어야 한다. 학습된 모델의 예측 정확도만 높아졌는지, 실제로 필요한 실험 횟수와 운용 시간이 줄었는지, 학습을 준비하는 데 든 비용까지 포함해 이득이 있는지를 구분해야 한다. 새로운 장치나 달라진 잡음 조건에서도 성능을 유지하는지, 기존의 물리 기반 방법과 결합했을 때 어떤 장점이 있는지도 중요하다. 이러한 비교가 축적되어야 개별 시연을 재사용 가능한 연구 방법으로 발전시킬 수 있다.
따라서, QML의 연구 성과에는 새로운 학습 알고리즘과 함께, 잘 정의된 양자 과제와 검증 절차도 포함되어야 한다. 어떤 데이터를 얻었고 어떤 자원을 사용했는지 비교할 수 있어야 후속 연구가 이어진다. 실험 데이터, 시뮬레이터, 제어 소프트웨어, 평가 기준을 함께 축적하는 일은 응용사례를 발견할 가능성을 높인다. 양자기술의 활용을 향한 투자가 연구개발의 방법 자체를 개선하는 효과로 이어질 수 있는 부분이다.
맺음말: 이제는 활용의 역량으로
국내에서도 양자기술의 산업화와 활용을 강화하려는 정책적 움직임이 이어지고 있다. 과학기술정보통신부는 2025년 퀀텀 이니셔티브 관련 발표에서, 하드웨어에 비해 소프트웨어 투자가 상대적으로 미흡했음을 짚고 알고리즘과 활용 연구의 지원을 강화하겠다는 방향을 제시했다[20]. 양자기술의 경쟁력을 장치와 활용 역량의 관점에서 함께 바라보기 시작했다는 점에서 의미가 있다.
이러한 방향이 QML 연구의 지속적인 기반으로 얼마나 빠르게 이어질지는 이제 더 주의 깊게 살펴볼 문제다. 양자컴퓨팅의 활용 가능성을 이야기하는 속도에 비해, 활용 방법 자체를 축적하는 연구에 주어지는 관심과 지원은 충분히 따라오고 있는가. 특히 기초 이론, AI 방법론, 양자 실험을 함께 다루는 연구는 성과가 하나의 지표로 드러나기까지 다소 시간이 걸릴 수 있다. 따라서, 이러한 특성을 이해하는 평가와 지원이 필요하다.
QML에 필요한 투자는 연구비의 규모와 함께 연구가 연결되는 방식에서도 생각해야 한다. 알고리즘 연구자가 실제 장치의 제약과 데이터를 접하고, 실험 연구자가 학습 모델을 제어 과정에 적용하며, 응용 연구자가 그 결과를 구체적인 문제에서 평가할 수 있어야 한다. 그러기 위해서는 각 분야의 연구자들이 함께할 그라운드가 필요하다. 장기간의 장치 접근, 데이터와 소프트웨어의 축적, 분야를 오가는 연구 인력의 성장이 함께 이루어질 때 개별 성과가 지속적인 역량으로 남을 것이다.
사실 AI for Quantum의 발전은 이러한 연결이 어떤 변화를 만드는지 계속 보여줬다. 측정 규칙을 찾던 학습은 알고리즘과 실험의 설계로 확장되었고, 양자상태의 표현을 거쳐 통신과 센서, 프로세서의 운용에 참여하게 되었다. 그 과정에서 양자정보처리의 성능이 개선되었으며, 양자계의 특성에 맞는 학습의 목표와 방법도 이미 많이 발전된 상태다. AI와 양자의 상호작용은 이미 여러 연구 단계에서 구체적인 문제를 푸는 방식이 되고 있다.
앞으로의 과제는 이 성과들을 새로운 활용과 응용으로 이어가는 것이다. 어떤 양자 자원이 필요한지, 그 자원을 어떻게 제어하고 읽어낼지, 얻은 결과로 다음 연구를 어떻게 개선할지를 함께 탐구해야 한다. 양자머신러닝은 이러한 질문들을 하나의 연구 과정 안에서 연결할 수 있다. 양자기술의 다음 도약을 준비하는 데에는 더 좋은 장치를 만드는 능력과 함께, 그 장치로부터 배우고 쓰임을 발견하고자 하는 전세계 연구 트렌드와 비전에 대한 이해가 필요하다.
참고문헌
- 1 Biamonte et al., “Quantum machine learning,” Nature 549, 195–202 (2017).
- 2Lee et al., “Learning unknown pure quantum states,” Physical Review A 98, 052302 (2018); Lee et al., “Quantum State Learning via Single-Shot Measurements,” Physical Review Letters 126, 170504 (2021).
- 3A. Hentschel and B. C. Sanders, “Machine Learning for Precise Quantum Measurement,” Physical Review Letters 104, 063603 (2010).
- 4 Bang, J. Ryu, S. Yoo, M. Pawłowski, and J. Lee, “A strategy for quantum algorithm design assisted by machine learning,” New Journal of Physics 16, 073017 (2014).
- 5M. Krenn et al., “Automated Search for New Quantum Experiments,” Physical Review Letters 116, 090405 (2016).
- 6A. A. Melnikov et al., “Active learning machine learns to create new quantum experiments,” Proceedings of the National Academy of Sciences 115, 1221–1226 (2018).
- 7M. Erhard et al., “Experimental Greenberger–Horne–Zeilinger entanglement beyond qubits,” Nature Photonics 12, 759–764 (2018).
- 8G. Carleo and M. Troyer, “Solving the quantum many-body problem with artificial neural networks,” Science 355, 602–606 (2017).
- 9G. Torlai et al., “Neural-network quantum state tomography,” Nature Physics 14, 447–450 (2018).
- 10-Y. Liu et al., “Practical Phase-Modulation Stabilization in Quantum Key Distribution via Machine Learning,” Physical Review Applied 12, 014059 (2019).
- 11 Wallnöfer et al., “Machine Learning for Long-Distance Quantum Communication,” PRX Quantum 1, 010301 (2020).
- 12R. Santagati et al., “Magnetic-Field Learning Using a Single Electronic Spin in Diamond with One-Photon Readout at Room Temperature,” Physical Review X 9, 021019 (2019).
- 13K. Reuer et al., “Realizing a deep reinforcement learning agent for real-time quantum feedback,” Nature Communications 14, 7138 (2023).
- 14 Bausch et al., “Learning high-accuracy error decoding for quantum processors,” Nature 635, 834–840 (2024).
- 15F. J. R. Ruiz et al., “Quantum circuit optimization with AlphaTensor,” Nature Machine Intelligence 7, 374–385 (2025).
- 16 Duan et al., “Concurrent spin squeezing and field tracking with machine learning,” Nature Physics 21, 909–915 (2025).
- 17[17] V. Sivak et al., “Reinforcement learning control of quantum error correction,” Nature 655, 879–884 (2026).
- 18[18] H.-Y. Huang et al., “Quantum advantage in learning from experiments,” Science 376, 1182–1186 (2022).
- 19 Klimesch et al., “Designing physics experiments with artificial intelligence,” Nature 657, 47–58 (2026).
- 20[20] 과학기술정보통신부, 「양자과학기술관련 브리핑」, 대한민국 정책브리핑, https://www.korea.kr/briefing/policyBriefingView.do?newsId=156678547#policyBriefing


관련 논문 보기
 퀀텀웨이브 정기출판물
뉴스레터 구독
파동의교차,지식의융합 양자세계의 최신소식을 받아보세요.
퀀텀웨이브에서 제공하는 콘텐츠

주목할 만한 최신 연구성과
양자물리학 분야의 혁신적 연구 결과를 쉽게 풀어서 소개하고 해설합니다

양자 세부분야 리뷰
양자컴퓨팅, 양자통신, 양자센서 등 각 분야별 심화 리뷰와 동향 분석

국내 연구실 연구 동향
국내 대학 및 연구기관의 양자 관련 연구 소식과 성과를 전해드립니다
주목할 만한 최신 연구
더 많은 내용보기
열린 강의실
Quantum for AI: 양자컴퓨팅은 인공지능에 어떻게 쓰일까
데이터 표현, 유사도 계산, 최적화, 확률분포의 표본추출 등 인공지능을 구성하는 여러 계산에 활용될 수 있으며, 이를 위한 다양한 양자 알고리즘과 학습모형이 연구되고 있다. 현재 연구의 대부분은 인공지능 시스템 전체를 양자컴퓨터로 구현하기보다, 특정 계산을 양자적으로 수행할 때 이점이 생기는지를 밝히는 데 집중되어 있다. 장기적으로는 데이터의 표현과 저장, 모델의 학습과 추론, 그리고 최적화와 탐색를 포함한 계산 전반을 양자컴퓨터에서 수행하는 구조도 생각할 수 있다. 그러나 이러한 전면적인 양자 구현이 원리적으로 가능하다는 것과 실제로 효율적이라는 것은 별개의 문제다. 초기 양자 기계학습은 선형 방정식을 빠르게 푸는 양자 알고리즘을 서포트 벡터 머신과 주성분분석에 적용해 큰 이론적 속도 향상을 제시했다. 그러나 이러한 결과는 대규모 데이터를 양자 상태로 빠르게 준비하고, 긴 회로를 정확하게 실행하며, 양자 상태에 담긴 결과에서 필요한 정보만 효율적으로 읽을 수 있다는 강한 조건을 요구한다. 또한 두 방법 모두 기본적으로 선형 분류와 선형 차원축소를 다루므로, 데이터에 적합한 비선형 표현을 스스로 학습하는 현대 딥러닝과는 해결하려는 문제가 다르다. 현재의 양자 장치에서 실행할 수 있는 양자 신경망과 양자 커널은 긴 회로에 대한 의존을 줄이면서 비선형 함수를 표현할 수 있다. 하지만 양자 신경망은 매개변수가 늘어날수록 기울기 계산에 필요한 회로 실행 횟수가 증가하고, 양자 커널은 데이터 수가 커질수록 유사도 계산량이 빠르게 늘어난다. 따라서 기존 딥러닝을 같은 방식으로 더 빠르게 실행하기보다는, 양자 장치가 자연스럽게 만들어 내는 확률분포와 표본을 생성 모델에 활용하는 방향이 더 적합할 수 있다. 특히 볼츠만 머신처럼 복잡한 확률분포에서 표본을 반복해서 뽑아야 하는 에너지 기반 모델은 양자 어닐링과 직접 연결될 수 있다. 어느 경우에도 데이터 입력, 반복 측정과 고전 최적화를 포함한 전체 비용을 비교해야 실제 양자 이득을 판단할 수 있다. .author_wrap .item2 { display: none; }
열린 강의실
AI for Quantum: 양자의 다음 도약, 학습에서 길을 찾다
양자기술의 가능성을 실제 성능으로 연결하기 위해서는 양자상태를 견고하게 만들고, 필요한 정보를 정교하게 읽어내며, 변화하는 환경에서도 장치를 안정적으로 작동시켜야 한다. 그러나 양자계의 규모와 복잡성이 커질수록 이러한 과정을 연구자의 직관과 수작업에만 맡기기는 어려워진다. AI for Quantum은 바로 이 지점에서 출발한다. 측정과 실험에서 얻은 정보를 학습하고, 그 결과를 다음 설계와 제어에 반영함으로써 양자정보과학의 오랜 병목을 풀어가고자 하는 접근이다. 2010년 전후의 초기 연구는 양자 측정의 피드백 규칙과 양자알고리즘의 핵심 모듈을 학습할 수 있는지 물었다. 이후 학습의 대상은 새로운 실험의 설계, 복잡한 양자상태의 표현과 재구성, 양자통신망의 운용, 센서의 신호 추정으로 넓어졌다. 최근에는 실시간 피드백과 양자오류정정에 AI가 적극 참여하면서, 좋은 설정을 한 번 찾는 단계를 넘어 장치가 작동하는 동안 성능을 유지하고 실시간으로 개선하는 방향으로 연구가 발전하고 있다. 이 과정은 AI가 양자 연구의 분석 도구에서 설계와 운용의 일부로 자리 잡아온 역사이기도 하다. 이 흐름은 양자머신러닝(Quantum Machine Learning, QML)을 이해하는 시야도 넓힌다. 고전 AI가 양자정보처리를 돕고, 양자 작업에서 얻은 데이터와 물리적 제약이 다시 학습의 목표와 방법을 바꾼다. QML의 전반적인 프레임워크에서 보자면, 이는 양자 자원의 이점이 학습의 효율 향상으로 자연스럽게 연결되는 것도 가능케한다. 이러한 상호작용을 발전시키는 QML은 양자컴퓨팅의 활용·응용사례를 발굴하고 연구개발 과정을 고도화할 매우 중요한 분야다. 양자기술의 확보와 함께, 그 기술을 어떻게 학습하고 활용할 것인지에 대한 연구역량을 축적해야 할 시점이 바로 지금이다.