열린강의실
Quantum for AI: 양자컴퓨팅은 인공지능에 어떻게 쓰일까
※ 본 이미지는 챗GPT(으)로 제작되었으며 퀀텀웨이브에서 가공하였습니다.
KEY SUMMARY
데이터 표현, 유사도 계산, 최적화, 확률분포의 표본추출 등 인공지능을 구성하는 여러 계산에 활용될 수 있으며, 이를 위한 다양한 양자 알고리즘과 학습모형이 연구되고 있다. 현재 연구의 대부분은 인공지능 시스템 전체를 양자컴퓨터로 구현하기보다, 특정 계산을 양자적으로 수행할 때 이점이 생기는지를 밝히는 데 집중되어 있다. 장기적으로는 데이터의 표현과 저장, 모델의 학습과 추론, 그리고 최적화와 탐색를 포함한 계산 전반을 양자컴퓨터에서 수행하는 구조도 생각할 수 있다. 그러나 이러한 전면적인 양자 구현이 원리적으로 가능하다는 것과 실제로 효율적이라는 것은 별개의 문제다.
초기 양자 기계학습은 선형 방정식을 빠르게 푸는 양자 알고리즘을 서포트 벡터 머신과 주성분분석에 적용해 큰 이론적 속도 향상을 제시했다. 그러나 이러한 결과는 대규모 데이터를 양자 상태로 빠르게 준비하고, 긴 회로를 정확하게 실행하며, 양자 상태에 담긴 결과에서 필요한 정보만 효율적으로 읽을 수 있다는 강한 조건을 요구한다. 또한 두 방법 모두 기본적으로 선형 분류와 선형 차원축소를 다루므로, 데이터에 적합한 비선형 표현을 스스로 학습하는 현대 딥러닝과는 해결하려는 문제가 다르다.
현재의 양자 장치에서 실행할 수 있는 양자 신경망과 양자 커널은 긴 회로에 대한 의존을 줄이면서 비선형 함수를 표현할 수 있다. 하지만 양자 신경망은 매개변수가 늘어날수록 기울기 계산에 필요한 회로 실행 횟수가 증가하고, 양자 커널은 데이터 수가 커질수록 유사도 계산량이 빠르게 늘어난다. 따라서 기존 딥러닝을 같은 방식으로 더 빠르게 실행하기보다는, 양자 장치가 자연스럽게 만들어 내는 확률분포와 표본을 생성 모델에 활용하는 방향이 더 적합할 수 있다. 특히 볼츠만 머신처럼 복잡한 확률분포에서 표본을 반복해서 뽑아야 하는 에너지 기반 모델은 양자 어닐링과 직접 연결될 수 있다. 어느 경우에도 데이터 입력, 반복 측정과 고전 최적화를 포함한 전체 비용을 비교해야 실제 양자 이득을 판단할 수 있다.
출발점은 인공지능 전체가 아니라 특정 계산
인공지능은 하나의 알고리즘이 아니다. 데이터를 수집하고 정리하는 과정부터 중요한 특징을 찾고, 예측하거나 새로운 자료를 생성하며, 여러 후보 가운데 행동을 선택하고 최적화하는 과정까지 다양한 계산이 연결되어 하나의 시스템을 이룬다. 딥러닝도 인공지능 전체를 뜻하는 것이 아니라, 이러한 시스템 안에서 데이터 표현과 예측 또는 생성을 담당하는 계산 방법이다.
양자 기계학습(quantum machine learning) 역시 다양한 범위를 포함한다. 장기적으로는 데이터의 저장과 처리, 모델의 학습과 추론을 포함한 계산 전반을 양자컴퓨터에서 수행하는 인공지능 시스템을 생각할 수 있다. 특히 입력 데이터와 중간 결과가 처음부터 양자정보로 주어지는 환경이라면, 계산 도중 이를 고전정보로 변환하지 않는 구조가 자연스러울 수 있다. 다만 현실의 인공지능은 대부분 이미지, 언어와 수치 자료처럼 고전적인 데이터를 입력으로 사용하고, 그 결과도 사람이 읽을 수 있는 고전정보로 내놓는다. 모든 계산을 양자로 수행할 수 있다는 원리적 가능성이 그러한 구성이 효율적이거나 실용적이라는 사실을 보장하지는 않는다.
현재 양자 기계학습 연구는 인공지능 시스템 전체를 양자로 구현하기보다, 그 시스템을 구성하는 개별 계산을 양자적으로 수행할 때 이점이 생기는지를 주로 다룬다 [1]. 예를 들어 고전 신경망이 데이터의 기본 특징을 추출하고 양자 장치가 일부 데이터의 유사도를 계산할 수 있다. 생성 모델에서는 데이터의 기본 표현과 학습 과정은 고전 컴퓨터가 담당하고, 특정한 확률분포에서 표본을 얻는 계산만 양자 장치에 맡길 수도 있다. 가까운 미래에 유용한 양자 인공지능이 등장한다면, 이처럼 고전 컴퓨터와 양자컴퓨터가 역할을 나누는 혼합형 시스템일 가능성이 크다.
이러한 관점에서는 양자컴퓨터가 큰 상태 공간을 표현할 수 있다는 사실만으로 인공지능 시스템 전체가 빨라진다고 결론 내릴 수 없다. 고전 데이터를 양자 상태로 바꾸는 데에도 계산이 필요하고, 확률이나 평균값을 정확하게 추정하려면 같은 회로를 여러 번 실행해야 한다. 양자 회로 안의 특정 연산이 빠르더라도 데이터 입력과 측정, 고전 전후처리에서 더 많은 시간이 걸릴 수 있다. 따라서 양자컴퓨팅이 인공지능에 제공하는 이점은 개별 양자 연산이 아니라 처음부터 끝까지 연결된 전체 계산 과정에서 평가해야 한다.
선형방정식 풀이와 초기 양자 기계학습
초기 양자 기계학습 연구는 머신러닝에서 반복해서 등장하는 선형대수 계산을 양자 알고리즘으로 가속하는 데 초점을 맞췄다. 대표적인 출발점은 이 알고리즘을 제안한 세 연구자의 성 첫 글자를 따서 이름 붙인 HHL(Harrow–Hassidim–Lloyd) 알고리즘이다. HHL은 행렬 \(\scriptstyle A\)와 벡터 \(\scriptstyle b\)로 주어진 선형 방정식 \(\scriptstyle Ax = b\)의 해를 양자 상태에 담는다. 행렬이 희소하고 수치적으로 안정적이며 입력 상태를 빠르게 만들 수 있다는 조건 아래, 문제 크기에 대해 매우 큰 이론적 속도 향상을 얻을 수 있다 [2]. 여기서는 HHL의 회로 자체보다 이 알고리즘이 머신러닝에 적용될 때 무엇이 달라지는지에 집중해 보자.
HHL을 최소제곱 서포트 벡터 머신(least-squares support vector machine)의 학습에 적용한 것이 양자 서포트 벡터 머신(quantum support vector machine, quantum SVM)이다 [3]. 서포트 벡터 머신(SVM)은 서로 다른 범주의 데이터를 나누는 경계를 찾는 예측 모델이다. 양자 SVM은 학습 과정에서 나타나는 선형 방정식을 HHL로 풀고, 새로운 데이터가 결정경계의 어느 쪽에 놓이는지를 측정한다. 필요한 조건이 모두 만족된다면 데이터 수가 커질 때 매력적인 복잡도 향상을 얻을 수 있다. 그러나 원래 제안된 양자 SVM의 기본 구조는 데이터 사이의 내적을 사용하는 선형 커널 모델이다. 선형 커널은 계산이 단순하지만 원래 입력 공간에서 직선이나 평면으로 구분하기 어려운 자료를 다루는 데 한계가 있다. 반면 현대 딥러닝은 여러 층을 거치며 예측에 필요한 비선형 표현을 데이터로부터 함께 학습한다. 따라서 선형 분류기의 학습을 빠르게 수행하는 것과 현대적인 표현학습을 빠르게 수행하는 것은 같은 문제가 아니다.
고전적인 커널 SVM에서도 데이터가 \(\scriptstyle N\)개이면 모든 데이터 쌍의 유사도를 담은 커널 행렬을 만드는 데 대체로 \(\scriptstyle N^2\)에 비례하는 계산과 저장 공간이 필요하다. 데이터가 매우 많아진 오늘날에는 이 비용이 큰 부담이다. 물론 선형 SVM, 확률적 최적화, 저차원 커널 근사처럼 이 부담을 줄이는 고전적 방법도 있다. 그러므로 양자 SVM 의 가치는 오래된 SVM 을 단순히 더 빠르게 만드는 데서 찾기보다, 고전적으로 계산하기 어려우면서도 예측에 유용한 양자적 유사도가 존재하는지를 묻는 쪽에서 찾아야 한다.
비슷한 시기에 제안된 양자 주성분분석(quantum principal component analysis, qPCA)도 큰 관심을 받았다 [4]. 주성분분석(principal component analysis, PCA)은 많은 변수로 표현된 데이터를 분산이 큰 몇 개의 방향으로 투영하는 선형 차원축소 방법이다. qPCA는 데이터의 공분산 구조를 밀도행렬이라는 양자 상태로 표현한 뒤, 밀도행렬 지수화(density matrix exponentiation)와 양자 위상추정(quantum phase estimation)을 이용해 큰 고윳값과 그에 대응하는 주성분에 접근한다. qPCA는 첫 번째 주성분 하나만 찾는 알고리즘은 아니며, 큰 고윳값을 가진 여러 성분을 그 비중에 따라 얻을 수 있다. 다만 qPCA가 내놓는 주성분은 좌표가 나열된 고전적 벡터가 아니라 양자 상태다. 이 상태를 다른 양자 알고리즘의 입력으로 바로 사용한다면 유용할 수 있지만, 모든 좌표를 고전적으로 읽으려면 많은 측정이 필요하다. 데이터의 밀도행렬을 효율적으로 준비해야 한다는 조건도 남는다. 밀도행렬 지수화와 양자 위상추정은 길고 정밀한 회로를 요구하므로, 큰 문제에서는 결함허용 양자컴퓨팅(fault-tolerant quantum computing)이 사실상 필요하다.
응용 측면에서도 PCA는 어디까지나 선형 투영이다. 데이터가 놓인 방향을 요약하고 시각화하는 데에는 지금도 유용하지만, 이미지와 언어처럼 복잡한 자료에서는 딥러닝이 과제에 맞는 비선형 표현을 직접 학습한다. qPCA의 이론적 속도 향상은 중요한 알고리즘 결과이지만, 그것이 곧 현대 인공지능의 핵심 병목을 해결한다는 뜻은 아니다.
이론적 속도 향상을 실제 성능으로 바꾸는 조건
초기 양자 기계학습 논문을 읽을 때에는 복잡도 식의 앞뒤를 함께 살펴야 한다 [5]. 첫째는 양자 상태 준비(state preparation)다. 길이가 \(\scriptstyle N\)인 고전 벡터를 \(\scriptstyle \log_2 N\)개의 큐비트가 가진 진폭에 담을 수 있다는 표현만 보면지수적으로 압축되는 것처럼 보인다. 그러나 일반적인 벡터의 \(\scriptstyle N\)개 값을 실제 진폭으로 기록하는 과정에는 \(\scriptstyle N\)에 비례하는 작업이 들 수 있다. 양자 임의 접근 메모리(quantum random-access memory, QRAM)를 이용해 이 과정을 빠르게 수행한다고 가정하는 경우가 많지만, 대규모 QRAM을 안정적으로 구현하는 일 자체가 해결되지 않은 공학적 과제다.
둘째는 출력 형식이다. HHL의 해는 \(\scriptstyle x\)의 모든 성분이 적힌 표가 아니라 \(\scriptstyle \ket{x}\)라는 양자 상태다. 필요한 답이 \(\scriptstyle x\)의 특정 평균값이거나 다음 양자 계산의 입력이라면 이 형식이 잘 맞는다. 반대로 모든 성분을 고전 컴퓨터에서 사용해야 한다면 양자 상태를 반복해서 측정하고 복원하는 비용이 이론적 이득을 없앨 수 있다. qPCA도 같은 문제를 가진다. 양자 상태로 얻은 주성분을 어디에 사용할 것인지가 알고리즘의 실용성을 좌우한다.
셋째는 정확도와 오류정정이다. HHL과 표준적인 양자 위상추정은 회로가 길고, 원하는 정확도가 높아질수록 필요한 자원이 증가한다. 현재의 잡음 있는 양자 장치에서 작은 원리 검증은 가능하지만, 큰 데이터 문제에서 이론적으로 예측된 속도 향상을 유지하려면 논리 큐비트를 사용하는 결함허용(fault-tolerant) 계산이 필요하다. 이때에는 논리 게이트 수뿐 아니라 오류정정에 필요한 물리 큐비트 수와 실행 시간도 계산에 포함해야 한다.
결국 비교해야 할 대상은 양자 회로의 한 부분이 아니라, 데이터를 읽어 들이는 순간부터 최종 답을 얻을 때까지의 전체 과정이다. 같은 정확도의 답을 얻기 위해 양자 상태 준비, 회로 실행, 반복 측정, 고전 후처리에 들어간 시간을 모두 더한 뒤 가장 좋은 고전 알고리즘과 비교해야 한다. 이러한 처음부터 끝까지의 총비용(end-to-end cost)을 빼고 제시한 속도 향상은 실제 응용 성능과 크게 다를 수 있다.
짧은 회로를 이용하는 양자 신경망
오류정정이 완성되기 전의 양자 장치에서도 기계학습을 시도하기 위해 연구자들은 비교적 짧은 회로를 사용하기 시작했다. 대표적인 방법이 매개변수화 양자 회로(parameterized quantum circuit, PQC)다. 회전각처럼 조절할 수 있는 값을 가진 양자 게이트를 연결하고, 회로의 측정값이 학습 자료에 맞도록 이 값들을 조정한다. 이러한 모델을 넓은 의미에서 양자 신경망(quantum neural network, QNN)이라고 부른다. 다만 고전 신경망의 뉴런과 층을 그대로 양자로 옮긴 것이라기보다, 학습 가능한 양자 회로라고 이해하는 편이 정확하다.
고전 데이터를 넣는 간단한 방법 가운데 하나는 데이터 반복 입력(data re-uploading)이다 [6]. 입력값을 회전각으로 바꾸어 회로의 여러 위치에 반복해서 넣고, 그 사이에 학습 가능한 게이트를 배치한다. 입력이 회로를 지날 때마다 서로 다른 주파수 성분이 만들어지므로, 충분한 구조를 가진 회로의 출력은 푸리에 급수처럼 다양한 함수를 근사할 수 있다 [7]. 양자 측정 자체는 양자 상태에 대해 선형이지만, 입력에 따라 달라지는 양자 게이트와 간섭을 거친 최종 출력은 원래 입력에 대한 비선형 함수가 된다.
이 점은 양자 신경망이 겉보기와 달리 단순한 선형 모델이 아님을 보여준다. 그러나 다양한 함수를 표현할 수 있다는 사실만으로 좋은 학습 모델이 되지는 않는다. 원하는 함수를 표현하는 매개변수를 실제 학습 과정에서 찾을 수 있어야 하고, 그 과정에 필요한 데이터와 회로 실행 횟수도 감당할 수 있어야 한다. 표현 가능성과 학습 가능성은 서로 다른 문제다.
양자 커널과 비선형 데이터 표현
양자 커널(quantum kernel)은 같은 문제를 다른 방식으로 다룬다. 커널 방법은 두 데이터가 얼마나 비슷한지를 계산한 뒤, 이 유사도를 이용해 분류나 회귀를 수행한다. 양자 커널에서는 입력 \(\scriptstyle x\)를 양자 상태 \(\scriptstyle \ket{\phi(x)}\)로 바꾸는 양자 특징 사상(quantum feature map)을 설계하고, 두 상태가 얼마나 겹치는지를 유사도로 사용한다 [8,9].
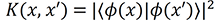
결정경계는 양자 상태가 놓인 특성 공간에서는 선형일 수 있지만, 원래 입력 \(\scriptstyle x\)에 대해서는 매우 비선형일 수 있다. 따라서 양자 커널을 선형 SVM과 동일하게 보는 것은 정확하지 않다. 핵심은 양자 회로가 만든 특성 공간이 고전 컴퓨터로 계산하기 어려우면서도 실제 자료의 범주나 연속값을 구분하는 데 유용한가에 있다.
양자 특성 공간이 고전적으로 모사하기 어렵다는 사실만으로 좋은 예측 성능이 보장되는 것도 아니다. 데이터와 무관하게 지나치게 복잡한 특징은 학습 자료를 구분할 수는 있어도 새로운 자료에는 일반화하지 못할 수 있다. 고전 모델이 데이터에 접근할 수 있는 양이 많아질수록 양자 모델의 이점이 줄어들 수 있다는 이론적 분석도 있다 [12]. 양자적 복잡성, 예측 정확도, 학습에 필요한 자료의 양을 함께 살펴야 한다.
표현력과 학습속도는 다르다
양자 신경망의 매개변수를 학습하려면 손실 함수가 어느 방향으로 변하는지 알아야 한다. 널리 쓰이는 매개변수 이동 규칙(parameter-shift rule)은 한 매개변수의 값을 양쪽으로 이동시킨 회로를 실행해 기울기를 구한다 [10]. 회로에 \(\scriptstyle P\)개의 매개변수가 있으면 일반적으로 한 번의 전체 기울기 계산에 \(\scriptstyle P\)에 비례하는 수의 회로 설정이 필요하고, 각 설정에서도 통계적 오차를 줄이기 위해 반복 측정을 해야 한다.
고전 신경망은 역전파(backpropagation)를 이용해 한 번의 순방향 계산과 역방향 계산으로 많은 매개변수의 기울기를 함께 구한다. 현재의 양자 장치에는 이와 같은 비용 구조의 역전파가 일반적으로 제공되지 않는다. 따라서 매개변수가 많은 양자 신경망을 대규모 딥러닝보다 빠르게 학습할 수 있다고 기대하기는 어렵다. 회로를 병렬로 실행하거나 기울기 추정법을 개선할 수는 있지만, 측정에 필요한 총표본 수가 사라지는 것은 아니다.
회로가 커질 때 기울기가 거의 0 으로 작아지는 현상도 나타날 수 있다 [11]. 이 경우 어느 방향으로 매개변수를 바꿔야 할지 판단하기 어려워지고, 장치 잡음과 유한한 측정 횟수가 문제를 더 심하게 만든다. 회로를 얕게 만들고 문제의 구조를 반영하면 학습이 쉬워질 수 있다. 그러나 회로가 지나치게 단순하면 고전 컴퓨터로도 쉽게 모사될 가능성이 커진다. 양자적으로 복잡하면서도 실제로 학습 가능한 회로를 찾는 것이 중요한 연구 주제인 이유다.
양자 특성 공간이 고전적으로 모사하기 어렵다는 사실만으로 좋은 예측 성능이 보장되는 것도 아니다. 데이터와 무관하게 지나치게 복잡한 특징은 학습 자료를 구분할 수는 있어도 새로운 자료에는 일반화하지 못할 수 있다. 고전 모델이 데이터에 접근할 수 있는 양이 많아질수록 양자 모델의 이점이 줄어들 수 있다는 이론적 분석도 있다 [12]. 양자적 복잡성, 예측 정확도, 학습에 필요한 자료의 양을 함께 살펴야 한다.
예측보다 생성이 더 자연스러울 수 있는 이유
지금까지의 양자 기계학습은 분류와 회귀 같은 예측 문제를 주로 다뤘다. 예측 모델은 하나의 입력에 대해 범주 하나나 수치 하나를 내놓는다. 이를 양자 회로로 구현하면 입력마다 양자 상태를 준비하고, 측정으로 얻는 전체 확률분포 가운데 하나 또는 몇 개의 평균값만 정확히 추정해야 한다. 양자 장치는 본래 확률적인 표본을 내놓는데, 많은 반복 측정 끝에 숫자 하나만 사용하는 셈이다.
생성 모델(generative model)의 목표는 다르다. 생성 모델은 개별 입력의 정답을 맞히기보다 학습 자료와 비슷한 새로운 표본을 만들어 내는 확률분포 자체를 배운다. 양자 회로를 측정하면 비트열이 확률적으로 나오므로, 회로를 확률분포 생성기로 직접 사용할 수 있다. Born rule을 이용한 양자 회로 생성 모델(quantum circuit Born machine, QCBM)이 대표적인 예다 [13]. 회로가 준비한 상태를 \(\scriptstyle \ket{\psi(\theta)}\)라고 하면 비트열 \(\scriptstyle z\)가 나올 확률은 다음과 같다.
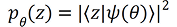
예를 들어 네 개의 큐비트를 측정하면 0000부터 1111까지 열여섯 개의 비트열 가운데 하나가 확률적으로 나온다. 회로의 게이트를 조절하면 각 비트열이 나올 확률도 달라진다. 학습 자료에서 자주 나타나는 패턴은 높은 확률로, 드문 패턴은 낮은 확률로 나오도록 회로를 조정하면 생성 모델이 된다. 예측 모델에서는 버려지기 쉬운 출력 분포 전체가 생성 모델에서는 바로 우리가 얻고 싶은 결과다.
고전 데이터를 입력마다 양자 상태로 바꾸는 부담도 일부 줄일 수 있다. 무조건부 생성 모델에서는 양자 회로에 고정된 초기 상태를 넣고, 학습 자료는 생성된 표본과 실제 자료의 차이를 계산하는 데 사용할 수 있다 [13]. 다만 상태 준비 문제가 완전히 사라지는 것은 아니다. 특정 조건에 맞는 결과를 만드는 조건부 생성에서는 조건 정보를 회로에 넣어야 하고, 손실 함수를 계산하기 위한 자료 처리와 반복 측정도 필요하다.
볼츠만 머신과 양자 표본추출
에너지 기반 모델(energy-based model)은 가능한 결과 \(\scriptstyle z\)마다 에너지 \(\scriptstyle E_\theta(z)\)를 부여하고, 에너지가 낮은 결과에 더 높은 확률을 주는 방식으로 데이터의 분포를 표현한다. 볼츠만 머신(Boltzmann machine)은 변수 사이의 상호작용을 이용해 이 에너지를 정하는 대표적인 에너지 기반 모델이다. 온도의 역수에 해당하는 \(\scriptstyle \beta\)와 정규화 상수 \(\scriptstyle Z_\theta\)를 쓰면 모델의 확률은 다음과 같이 나타낼 수 있다.
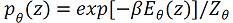
이를 지형에 비유하면 데이터에서 자주 나타나는 결과는 낮은 골짜기에, 잘 나타나지 않는 결과는 높은 언덕에 놓인다. 에너지 기반 모델의 장점은 각 결과의 확률을 일일이 직접 지정하지 않고, 결과들 사이의 상대적인 에너지 관계로 복잡한 확률분포를 표현할 수 있다는 점이다. 여러 개의 골짜기를 만들면 서로 다른 유형의 자료가 함께 존재하는 다봉분포를 나타낼 수 있고, 변수 사이의 상호작용을 에너지 함수에 넣으면 여러 특징이 함께 나타나는 경향도 학습할 수 있다.
볼츠만 머신(Boltzmann machine)은 변수 사이의 상호작용을 이용해 에너지 지형을 만드는 대표적인 에너지 기반 모델이다. 예를 들어 두 변수가 자주 함께 나타난다면 두 변수가 같은 상태를 가질 때 에너지가 낮아지도록 상호작용을 학습할 수 있다. 이러한 상호작용이 여러 변수에 연결되면, 각 변수를 독립적으로 다루는 분포보다 복잡한 상관관계를 표현할 수 있다. 볼츠만 머신은 이처럼 복잡한 분포를 학습하고, 학습된 분포에서 새로운 표본을 생성하며, 일부 변수의 값이 주어졌을 때 나머지 변수의 분포를 추론하는 데 사용할 수 있다.
조건부 생성도 같은 에너지 지형을 이용해 자연스럽게 구현할 수 있다. 무조건부 생성에서는 학습된 에너지 지형의 여러 골짜기에서 표본을 뽑는다. 특정한 조건에 맞는 결과를 만들고 싶다면 일부 변수의 값을 고정하거나 외부 편향장(bias field)을 더해 에너지 지형을 기울일 수 있다. 그러면 원하는 조건과 관련된 영역의 에너지가 낮아지고, 표본이 그 영역에서 나올 가능성이 커진다. 즉 조건마다 새로운 생성 모델을 처음부터 다시 학습하는 대신, 이미 학습된 분포를 유지한 채 생성 단계에서 표본이 나오는 방향을 조절할 수 있다. 학습된 변수 간 상호작용은 특정 변수에 가한 편향을 다른 변수로 전달하므로, 조건과 관련된 여러 특징이 함께 변하는 결과도 만들 수 있다.
볼츠만 머신을 학습하려면 모델이 만드는 분포가 학습 자료의 분포에 가까워지도록 에너지 지형을 조정해야한다. 이를 위해 학습 자료에 나타나는 상태와 현재 모델이 생성하는 상태를 비교해야 하므로, 모델 분포에서 표본을 반복해서 뽑는 과정이 필요하다. 변수와 상호작용이 많아지면 가능한 상태의 수가 지수적으로 증가하고, 서로 멀리 떨어진 에너지 골짜기 사이를 이동하기도 어려워진다. 그 결과 정확한 표본을 충분히 얻는 과정이 볼츠만 머신 학습의 주요 병목이 된다.
양자 어닐러(quantum annealer)는 볼츠만 머신의 에너지 함수와 같은 형태의 아이징 스핀 모형(Ising spin model)을 장치에 직접 구현하고, 측정할 때마다 하나의 비트열을 내놓는다. 최적화에서는 가장 에너지가 낮은 상태 하나를 찾는 데 관심을 두지만, 생성 모델에서는 여러 번 측정해 얻은 비트열의 분포 자체가 중요하다. 따라서 양자 어닐러는 최적화 장치뿐 아니라 복잡한 에너지 지형에서 표본을 얻는 물리적 표본추출기로도 사용할 수 있다. 최근 연구에서는 충분히 천천히 바닥상태를 따라가는 방식 대신 짧은 시간에 실행하는 비단열 양자 어닐링(diabatic quantum annealing)을 이용해 표본의 유효 온도를 조절하는 방법이 제안되었다. 실제 양자 어닐러로 제한 볼츠만 머신(restricted Boltzmann machine)을 학습한 실험에서는 해당 조건에서 고전 표본추출보다 빠른 수렴과 낮은 검증 오차가 관찰되었다. 장치의 유효 온도가 목표 온도와 어긋나는 문제를 보정하기 위해 학습 매개변수를 다시 조정하는 방법도 함께 제시되었다 [14]. 다만 이는 특정 장치와 실험 조건에서 얻은 결과로, 일반적인 양자 우위가 검증되었다는 의미는 아니다. 이 접근을 생성표현학습으로 확장한 연구에서는 볼츠만 분포를 잠재변수의 사전분포로 사용하는 변분 오토인코더(variational autoencoder)에 세 가지 양자 어닐링 방식을 결합했다. 학습에는 빠른 비단열 실행을 사용하고, 학습을 마친 뒤 새로운 자료를 생성할 때에는 더 느린 실행을 사용했다. 특정 입력 조건에 맞는 자료를 생성할 때에는 일부 변수를 고정한 조건부 실행을 적용했다. D-Wave Advantage2 의 최대 2,000 큐비트를 이용해 MNIST, Fashion-MNIST와 CelebA 자료에 적용한 결과도 보고되었다 [15].
볼츠만 모델은 생성 외의 학습 구조에도 적용할 수 있다. 또 다른 최근 연구에서는 트랜스포머의 어텐션(attention)에 Ising spin 상호작용을 도입해 여러 토큰이 협력적으로 선택되도록 하는 볼츠만 어텐션(Boltzmann attention)을 제안했다 [16]. 표준 어텐션은 질의와 각 토큰 사이의 유사도를 개별적으로 계산한 뒤 이를 정규화해 가중치를 정한다. 반면 볼츠만 어텐션은 토큰의 선택 여부를 확률변수로 두고 토큰 쌍 사이에 학습 가능한 상호작용을 부여한다. 이를 통해 어떤 토큰들이 함께 선택되거나 서로 배제되는지를 하나의 어텐션 층 안에서 직접 표현할 수 있다. 표준 트랜스포머에서는 여러 층을 거치며 간접적으로 형성될 수 있는 토큰 간 상관관계를 더 얕은 구조에서 포착할 가능성이 있다는 점이 중요한 차이다. 문자 단위 언어 모델링과 괄호 짝맞추기 과제를 통해 이러한 가능성을 살펴보았으며, 비단열 양자 어닐링 과정은 트로터 분해(Trotter decomposition)를 이용한 수치 시뮬레이션으로 구현하였다. 현재 결과는 원리 검증 단계에 가깝지만, 기존 딥러닝을 단순히 빠르게 실행하는 것을 넘어 양자 통계모형의 상호작용 구조와 표본추출을 이용해 새로운 학습 구조를 설계할 수 있음을 보여준다.
생성과 표본추출이 흥미로운 또 다른 이유는 계산 복잡도에 있다. Instantaneous quantum polynomial-time (IQP) 회로는 모든 큐비트를 0으로 준비한 상태에서 시작한다. 먼저 각 큐비트에 하다마드 게이트(Hadamard gate)를 적용해 0과 1이 중첩된 상태를 만든다. 그다음 비트열마다 서로 다른 양자 위상을 부여하는 게이트들을 적용하고, 다시 하다마드 게이트를 거친 뒤 각 큐비트를 0 또는 1로 측정한다. 0과 1로 결과를 읽는 이 측정 방식을 계산 기저(computational basis) 측정이라고 한다. 회로 가운데에서 위상을 부여하는 게이트들은 서로 가환한다(commute). 이는 게이트를 적용하는 순서를 바꾸어도 최종 연산이 달라지지 않는다는 뜻이다. 첫 번째 하다마드 게이트가 여러 비트열의 중첩을 만들고, 가운데 게이트들이 각 비트열의 위상을 다르게 바꾸면, 마지막 하다마드 게이트를 통과할 때 이 위상들이 서로 보강되거나 상쇄된다. 이러한 양자 간섭이 최종적으로 각 비트열이 측정될 확률을 결정한다. IQP의 ‘순간적’이라는 이름은 실제 양자컴퓨터에서 회로가 시간 없이 실행된다는 뜻이 아니다. 가운데의 위상 게이트들 사이에 정해진 실행 순서가 필요하지 않다는 수학적 구조를 가리킨다. 실제 장치에서는 게이트 실행과 측정에 시간이 필요하고, 같은 큐비트를 사용하는 여러 게이트를 모두 동시에 실행할 수 있는 것도 아니다. 이처럼 회로의 구조는 비교적 단순하지만, 일반적인 IQP 회로의 출력분포에서 표본을 뽑는 일은 일정한 계산복잡도 가정 아래에서 고전 컴퓨터로 효율적으로 수행하기 어렵다고 여겨진다. 반면 생성모형의 학습에 필요한 특정 관측량의 평균과 최대평균차이(maximum mean discrepancy, MMD) 손실 함수는 IQP 회로의 구조를 이용해 고전 컴퓨터에서 효율적으로 추정할 수 있다. 따라서 학습은 고전 컴퓨터에서 수행하고, 학습된 회로에서 새로운 표본을 생성하는 단계는 양자컴퓨터에서 실행하는 방식을 생각할 수 있다 [17]. 학습에 필요한 일부 정보를 고전적으로 계산할 수 있다는 사실이 회로의 전체 출력분포까지 고전적으로 쉽게 생성할 수 있다는 뜻은 아니다. 이러한 차이는 양자 생성모형에서 학습과 표본추출의 역할을 분리할 수 있는 가능성을 제시한다.
그러나 고전적으로 모사하기 어렵다는 사실과 유용한 생성 결과를 만든다는 사실은 다르다. 회로가 실제 자료의 분포를 얼마나 잘 배우는지, 보지 못한 자료에도 일반화하는지, 학습에 필요한 표본 수와 실행 시간이 얼마나 되는지를 검증해야 한다. 가장 모사하기 어려운 분포가 가장 가치 있는 분포라는 보장도 없다. 계산 복잡도상의 어려움과 실제 과제에서의 성능을 구분하는 것이 중요하다.
양자 이득을 찾기 위한 연구 질문
양자 기계학습의 연구 질문은 기존 인공지능을 그대로 더 빠르게 실행하는 데 머물 필요가 없다. 오히려 양자 장치의 출력 형식과 계산 구조가 잘 맞는 문제를 찾는 편이 자연스럽다. 변수 사이의 상관관계가 복잡하고 확률분포에서 표본을 얻는 과정이 전체 계산의 병목인 문제, 또는 입력 데이터 자체가 양자 상태인 문제가 후보가 될 수 있다.
입력이 양자적인 경우에는 고전 데이터를 양자 상태로 변환하는 부담이 처음부터 줄어든다. 양자실험이나 양자통신망에서 만들어진 상태를 모두 고전 데이터로 복원하지 않고 바로 분류하거나 특징을 추출할 수 있다면 양자 기계학습의 장점이 더 자연스럽게 나타날 수 있다. 이는 일반적인 이미지나 언어 모델을 대체하는 문제와는 다르지만, 양자 과학에서 만들어지는 데이터를 분석한다는 분명한 연구 목적을 가진다. 비교 대상도 신중하게 정해야 한다. 양자 모델을 교과서적인 고전 알고리즘과 비교해서는 충분하지 않다. 그래픽 처리 장치(graphics processing unit, GPU)를 이용한 최신 딥러닝, 근사 커널, 고전 생성 모델과 표본추출 방법을 포함해 같은 문제에서 가장 경쟁력 있는 방법과 비교해야 한다. 정확도만이 아니라 학습 시간, 예측 시간, 필요한 자료의 양, 에너지 사용량처럼 실제로 의미 있는 기준도 함께 제시해야 한다.
마지막으로 양자 회로 밖의 비용을 숨기지 않아야 한다. 회로 실행 시간, 같은 회로의 반복 측정 횟수, 클라우드 대기 시간, 데이터 전송, 고전 최적화와 후처리를 모두 포함해야 한다. 양자 모델과 고전 모델이 서로 다른 품질의 답을 낸다면 같은 정확도나 같은 생성 품질에 도달하는 데 필요한 총비용으로 비교해야 한다. 그래야 작은 실험에서 관찰한 흥미로운 현상과 재현 가능한 양자 이득을 구분할 수 있다.
맺음말
양자컴퓨터가 인공지능에 기여할 가능성을 딥러닝의 단순한 대체로 설명하기는 어렵다. 초기의 양자 SVM과 qPCA는 머신러닝의 선형대수 계산에 양자 알고리즘을 적용했을 때 큰 속도 향상이 가능함을 보여주었다. 동시에 데이터 입력, 양자 상태로 주어지는 출력, 오류정정 비용을 함께 보지 않으면 이론적 속도 향상을 실제 성능으로 오해할 수 있다는 교훈도 남겼다.
짧은 회로를 사용하는 양자 신경망과 양자 커널은 비선형 데이터 표현을 만들 수 있지만, 학습과 유사도 계산을 위해 양자 회로를 매우 많이 반복해야 한다. 다양한 함수를 표현할 수 있다는 이론적 능력과 그 함수를 효율적으로 학습할 수 있다는 능력도 구분해야 한다. 이러한 비용 구조를 고려하면 현재의 대규모 딥러닝을 같은 방식으로 더 빠르게 실행한다는 목표에는 아직 강한 근거가 부족하다.
반면 생성 모델과 표본추출은 양자 장치가 확률분포를 직접 만든다는 성질을 결과로 활용한다. 볼츠만 머신과 같은 에너지 기반 모델은 표본추출 자체가 학습의 병목이 될 수 있어, 양자 어닐러의 출력 분포를 직접 활용할 수 있는 구체적인 사례를 제공한다. 이 방향도 자동으로 양자 이득을 보장하지는 않는다. 앞으로의 핵심 과제는 양자 인공지능이라는 큰 이름을 내세우는 것이 아니라, 인공지능 시스템을 이루는 여러 계산 가운데 어느 부분에서 측정 가능하고 재현 가능한 양자 이득이 생기는지를 하나씩 밝히는 일이다.
참고문헌
- 1J. Biamonte et al., “Quantum machine learning,” Nature 549, 195–202 (2017).
- 2 W. Harrow, A. Hassidim, and S. Lloyd, “Quantum algorithm for linear systems of equations,” Physical Review Letters 103, 150502 (2009).
- 3P. Rebentrost, M. Mohseni, and S. Lloyd, “Quantum support vector machine for big data classification,” Physical Review Letters 113, 130503 (2014).
- 4S. Lloyd, M. Mohseni, and P. Rebentrost, “Quantum principal component analysis,” Nature Physics 10, 631–633 (2014).
- 5S. Aaronson, “Read the fine print,” Nature Physics 11, 291–293 (2015).
- 6 Pérez-Salinas et al., “Data re-uploading for a universal quantum classifier,” Quantum 4, 226 (2020).
- 7M. Schuld, R. Sweke, and J. J. Meyer, “Effect of data encoding on the expressive power of variational quantum-machine-learning models,” Physical Review A 103, 032430 (2021).
- 8M. Schuld and N. Killoran, “Quantum machine learning in feature Hilbert spaces,” Physical Review Letters 122, 040504 (2019).
- 9V. Havlíček et al., “Supervised learning with quantum-enhanced feature spaces,” Nature 567, 209–212 (2019).
- 10M. Schuld et al., “Evaluating analytic gradients on quantum hardware,” Physical Review A 99, 032331 (2019).
- 11J. R. McClean et al., “Barren plateaus in quantum neural network training landscapes,” Nature Communications 9, 4812 (2018).
- 12H.-Y. Huang et al., “Power of data in quantum machine learning,” Nature Communications 12, 2631 (2021).
- 13J.-G. Liu and L. Wang, “Differentiable learning of quantum circuit Born machines,” Physical Review A 98, 062324 (2018).
- 14G. Kim, J.-Y. Gyhm, and D. K. Park, “Diabatic quantum annealing for training energy-based generative models,” Physical Review E 113, 035302 (2026).
- 15G. Kim and D. K. Park, “Multi-Mode Quantum Annealing for Generative Representation Learning with Boltzmann Priors,” arXiv:2604.00919 (2026).
- 16G. Kim and D. K. Park, “Boltzmann Attention: Learnable Ising Couplings for Cooperative Attention,” arXiv:2606.12478 (2026).
- 17E. Recio-Armengol, S. Ahmed, and J. Bowles, “Train on classical, deploy on quantum: scaling generative quantum machine learning to a thousand qubits,” arXiv:2503.02934 (2025).


관련 논문 보기
 퀀텀웨이브 정기출판물
뉴스레터 구독
파동의교차,지식의융합 양자세계의 최신소식을 받아보세요.
퀀텀웨이브에서 제공하는 콘텐츠

주목할 만한 최신 연구성과
양자물리학 분야의 혁신적 연구 결과를 쉽게 풀어서 소개하고 해설합니다

양자 세부분야 리뷰
양자컴퓨팅, 양자통신, 양자센서 등 각 분야별 심화 리뷰와 동향 분석

국내 연구실 연구 동향
국내 대학 및 연구기관의 양자 관련 연구 소식과 성과를 전해드립니다
주목할 만한 최신 연구
더 많은 내용보기
열린 강의실
Quantum for AI: 양자컴퓨팅은 인공지능에 어떻게 쓰일까
데이터 표현, 유사도 계산, 최적화, 확률분포의 표본추출 등 인공지능을 구성하는 여러 계산에 활용될 수 있으며, 이를 위한 다양한 양자 알고리즘과 학습모형이 연구되고 있다. 현재 연구의 대부분은 인공지능 시스템 전체를 양자컴퓨터로 구현하기보다, 특정 계산을 양자적으로 수행할 때 이점이 생기는지를 밝히는 데 집중되어 있다. 장기적으로는 데이터의 표현과 저장, 모델의 학습과 추론, 그리고 최적화와 탐색를 포함한 계산 전반을 양자컴퓨터에서 수행하는 구조도 생각할 수 있다. 그러나 이러한 전면적인 양자 구현이 원리적으로 가능하다는 것과 실제로 효율적이라는 것은 별개의 문제다. 초기 양자 기계학습은 선형 방정식을 빠르게 푸는 양자 알고리즘을 서포트 벡터 머신과 주성분분석에 적용해 큰 이론적 속도 향상을 제시했다. 그러나 이러한 결과는 대규모 데이터를 양자 상태로 빠르게 준비하고, 긴 회로를 정확하게 실행하며, 양자 상태에 담긴 결과에서 필요한 정보만 효율적으로 읽을 수 있다는 강한 조건을 요구한다. 또한 두 방법 모두 기본적으로 선형 분류와 선형 차원축소를 다루므로, 데이터에 적합한 비선형 표현을 스스로 학습하는 현대 딥러닝과는 해결하려는 문제가 다르다. 현재의 양자 장치에서 실행할 수 있는 양자 신경망과 양자 커널은 긴 회로에 대한 의존을 줄이면서 비선형 함수를 표현할 수 있다. 하지만 양자 신경망은 매개변수가 늘어날수록 기울기 계산에 필요한 회로 실행 횟수가 증가하고, 양자 커널은 데이터 수가 커질수록 유사도 계산량이 빠르게 늘어난다. 따라서 기존 딥러닝을 같은 방식으로 더 빠르게 실행하기보다는, 양자 장치가 자연스럽게 만들어 내는 확률분포와 표본을 생성 모델에 활용하는 방향이 더 적합할 수 있다. 특히 볼츠만 머신처럼 복잡한 확률분포에서 표본을 반복해서 뽑아야 하는 에너지 기반 모델은 양자 어닐링과 직접 연결될 수 있다. 어느 경우에도 데이터 입력, 반복 측정과 고전 최적화를 포함한 전체 비용을 비교해야 실제 양자 이득을 판단할 수 있다. .author_wrap .item2 { display: none; }
열린 강의실
AI for Quantum: 양자의 다음 도약, 학습에서 길을 찾다
양자기술의 가능성을 실제 성능으로 연결하기 위해서는 양자상태를 견고하게 만들고, 필요한 정보를 정교하게 읽어내며, 변화하는 환경에서도 장치를 안정적으로 작동시켜야 한다. 그러나 양자계의 규모와 복잡성이 커질수록 이러한 과정을 연구자의 직관과 수작업에만 맡기기는 어려워진다. AI for Quantum은 바로 이 지점에서 출발한다. 측정과 실험에서 얻은 정보를 학습하고, 그 결과를 다음 설계와 제어에 반영함으로써 양자정보과학의 오랜 병목을 풀어가고자 하는 접근이다. 2010년 전후의 초기 연구는 양자 측정의 피드백 규칙과 양자알고리즘의 핵심 모듈을 학습할 수 있는지 물었다. 이후 학습의 대상은 새로운 실험의 설계, 복잡한 양자상태의 표현과 재구성, 양자통신망의 운용, 센서의 신호 추정으로 넓어졌다. 최근에는 실시간 피드백과 양자오류정정에 AI가 적극 참여하면서, 좋은 설정을 한 번 찾는 단계를 넘어 장치가 작동하는 동안 성능을 유지하고 실시간으로 개선하는 방향으로 연구가 발전하고 있다. 이 과정은 AI가 양자 연구의 분석 도구에서 설계와 운용의 일부로 자리 잡아온 역사이기도 하다. 이 흐름은 양자머신러닝(Quantum Machine Learning, QML)을 이해하는 시야도 넓힌다. 고전 AI가 양자정보처리를 돕고, 양자 작업에서 얻은 데이터와 물리적 제약이 다시 학습의 목표와 방법을 바꾼다. QML의 전반적인 프레임워크에서 보자면, 이는 양자 자원의 이점이 학습의 효율 향상으로 자연스럽게 연결되는 것도 가능케한다. 이러한 상호작용을 발전시키는 QML은 양자컴퓨팅의 활용·응용사례를 발굴하고 연구개발 과정을 고도화할 매우 중요한 분야다. 양자기술의 확보와 함께, 그 기술을 어떻게 학습하고 활용할 것인지에 대한 연구역량을 축적해야 할 시점이 바로 지금이다.