열린강의실
샘플 기반 양자 대각화(SQD)의 원리와 응용 : 전자구조 계산의 기초에서 단백질–리간드 복합체까지
※ 본 이미지는 챗GPT(으)로 제작되었으며 퀀텀웨이브에서 가공하였습니다.
KEY SUMMARY
분자의 구조와 결합을 이해하려면, 그 안의 전자들이 어떤 상태를 이루고 얼마만큼의 에너지를 갖는지 알아야 합니다. 양자화학에서는 이를 양자역학으로 설명하고 계산하지만, 전자 상태를 표현하는 데 필요한 배치의 수가 급격히 늘어나면서 정밀한 계산이 어려워집니다. 따라서 중요한 정보를 유지하면서 계산 규모를 줄이는 것이 핵심 과제이며, 양자컴퓨터와 고전컴퓨터가 계산의 역할을 나누는 접근이 그 해결 방법으로 연구되고 있습니다.
샘플 기반 양자 대각화(Sample-based Quantum Diagonalization, SQD)는 이러한 협력을 활용하는 알고리즘입니다. 양자컴퓨터는 측정을 통해 전자 배치의 후보를 제공하고, 고전컴퓨터는 그 후보들을 조합해 에너지가 가장 낮은 상태를 구합니다. 이 글에서는 전자구조 계산의 기초에서 출발해 SQD의 원리와 두 컴퓨터의 역할을 살펴봅니다. 이어서 IBM·클리블랜드 클리닉·일본 이화학연구소(RIKEN)가 수행한 12,635개 원자를 포함하는 단백질–리간드 계의 계산 사례를 통해, 큰 분자에 이 방법을 적용하는 과정과 그 의미를 알아보겠습니다. [1, 2]
분자의 에너지는 전자들이 결정한다
많은 약물은 몸속 단백질에 결합하여 그 기능을 바꿉니다. 이러한 약물의 성분처럼, 단백질에 결합하는 상대 분자를 ‘리간드’라고 부릅니다. 그런데 약물이 될 만한 후보 물질은 매우 많고, 각각의 결합 특성을 실험으로 확인하려면 많은 시간과 비용이 듭니다. 따라서 어떤 리간드가 단백질에 잘 결합할지 미리 예측할 수 있다면, 실험할 후보를 좁히고 시행착오를 줄이는 데 도움이 됩니다.
그렇다면 컴퓨터로 단백질과 리간드의 결합을 어떻게 예측할 수 있을까요? 한 가지 방법은 두 분자가 서로 떨어져 있을 때와 결합했을 때의 에너지를 비교하는 것입니다. 단백질을 \(P\), 리간드를 \(L\), 둘이 결합한 계를 \(PL\)이라고 하면, 결합에너지를 다음과 같이 정의할 수 있습니다.
이 값이 음수라면 결합한 계의 에너지가 두 구성 요소의 에너지 합보다 낮다는 뜻입니다. 즉, 비교할 구조와 계산 조건을 정했을 때 결합이 에너지 측면에서 유리하다는 것을의미합니다. 뒤에서 살펴볼 IBM 공동연구에서도 이러한 에너지 차이를 계산합니다. [1]
물론 실제 약물이 단백질에 얼마나 잘 결합하는지는 에너지 차이만으로 결정되지 않습니다. 분자의 구조 변화, 온도, 주변 물 분자, 엔트로피 등 다양한 요인도 영향을 미칩니다. 그럼에도 결합 전후의 에너지 차이는 분자 사이의 상호작용을 이해하는 중요한 출발점입니다.
그렇다면 이러한 에너지는 어떻게 계산할 수 있을까요? 분자는 원자핵과 전자로 이루어져 있으며, 이들 사이에는 여러 상호작용이 존재합니다. 양전하를 띤 원자핵과 음전하를 띤 전자는 서로 끌어당기지만, 전자들끼리 또는 원자핵들끼리는 서로 밀어냅니다. 전자들은 이러한 상호작용의 영향을 동시에 받으며, 그 상태는 양자역학의 원리를 따릅니다.
이러한 원리를 바탕으로 분자의 에너지와 성질을 설명하고 계산하는 분야가 ‘양자화학’입니다. 그중에서도 원자의 종류와 위치 등의 정보로부터 전자들이 어떤 상태를 이루는지, 그리고 그 에너지가 얼마인지를 구하는 일을 ‘전자구조 계산’이라고 합니다.
전자구조 계산에서는 흔히 원자핵의 위치를 고정한 채 전자의 상태를 구합니다. 이는 원자핵이 전자보다 훨씬 무거워 보통 더 느리게 움직인다는 점을 이용한 접근으로, 보른–오펜하이머 근사에 기초합니다.
이렇게 원자핵의 배치와 전자 수가 주어졌을 때, 에너지가 가장 낮은 전자 상태를 ‘바닥상태’라고 합니다. 외부에서 전자를 들뜨게 할 만큼의 에너지가 주어지지 않는 조건에서는, 보통 전자들이 바닥상태에 있다고 보고 분자를 설명합니다. 따라서 서로 다른 분자 구조에서 바닥상태의 에너지를 계산하고 비교하면, 어느 구조가 에너지 측면에서 더 안정한지 알아볼 수 있습니다.
이처럼 전자구조 계산은 분자의 에너지를 구하고, 나아가 분자 사이의 결합을 이해하는 데 필요한 기초를 제공합니다. 그러나 문제는 그 기초가 되는 전자들의 상태를 정확하게 계산하는 일부터 만만하지 않다는 것입니다.
전자구조 계산의 어려움: 전자 배치와 부분공간 대각화
전자는 행성처럼 정해진 궤도를 도는 작은 공으로 설명할 수 없습니다. 대신, 전자의 상태는 공간에 퍼져 있는 파동함수로 기술합니다. 이때 전자 하나의 공간적 상태를 나타내는 파동함수를 ‘오비탈(orbital)’이라고 부릅니다. 전자 여러 개가 모여있는 상태를 표현하려면, 먼저 계산에 사용할 오비탈을 정하고 전자들이 이러한 오비탈을 어떻게 차지하는지 표현해야 합니다.
여기서 전자가 지닌 또 하나의 양자적 성질인 ‘스핀(spin)’을 고려해야 합니다. 전자의 스핀은 흔히 위(up)와 아래(down)의 두 상태로 구분합니다. 하나의 공간 오비탈에 각각의 스핀 상태를 결합하면 두 개의 ‘스핀 오비탈(spin orbital)’이 만들어집니다. 따라서 공간 오비탈 두 개를 사용하면, 위와 아래 스핀을 각각 구분하여 모두 네 개의 스핀 오비탈을 얻습니다(그림 1A). 각 스핀 오비탈에는 전자가 최대 한 개만 들어갈 수 있으므로, 전자가 없으면 0, 있으면 1로 나타낼 수 있습니다.
이를 극장의 좌석표에 비유해 봅시다. 각각의 스핀 오비탈이 하나의 좌석이고, 전자는 그 좌석을 차지하는 관객에 해당합니다. 빈 좌석을 0, 찬 좌석을 1로 표시하면, 예를 들어 ‘1100’은 네 개의 좌석 중 앞의 두 개가 채워진 상태를 뜻합니다. 이처럼 어느 스핀 오비탈에 전자가 들어 있는지를 나타낸 것이 ‘전자 배치(electron configuration)’입니다.
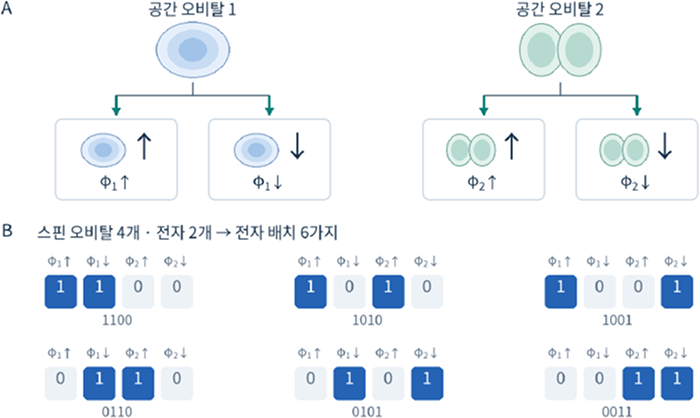
그림 1: 공간 오비탈에서 전자 배치까지. (A) 공간 오비탈 \(\phi_1, \phi_2\)에 각각 위(\(\uparrow\))와 아래(\(\downarrow\)) 스핀을 결합하면 네 개의 스핀 오비탈을 얻는다. 같은 공간 오비탈에 대응하는 두 스핀 오비탈은 공간적 모양이 같고 스핀 상태가 다르다. (B) 이 네 스핀 오비탈을 왼쪽부터 \(\phi_1\uparrow, \phi_1\downarrow, \phi_2\uparrow, \phi_2\downarrow\) 순서로 놓고 전자 두개를 배치하면 여섯 가지 경우의 수를생각할 수 있다. 1은 점유, 0은 비점유를 뜻하며, 서로 다른 전자를 구분하지 않는다.
일반적으로, 스핀 오비탈이 \(K\)개이고 전자가 \(N\)개라면, 전자 수만 고정했을 때 가능한 배치의 수 \(D\)는 다음과 같습니다.
앞선 예시에서는 \(\binom{4}{2}=6\)이므로 가능한 배치의 수는 여섯 가지입니다. 한편, 스핀 오비탈 100개에 전자 50개라면 \(\binom{100}{50}\approx 1.01\times10^{29}\)가지에 달합니다. 전자 50개는 생각보다 큰 규모가 아닙니다. 예를 들어, 벤젠(\(\mathrm{C_6H_6}\)) 분자는 전자가 42개이고, 톨루엔(\(\mathrm{C_7H_8}\)) 분자는 50개입니다. 약물 후보로 사용되는 리간드에는 수백 개의 전자가 포함될 수 있으며, 단백질 전체에는 수천에서 수만 개 이상의 전자가 존재할 수 있습니다. 물론 스핀이나 대칭성과 같은 조건을 적용하거나 계산에 중요한 오비탈만 선택하면 고려해야 할 배치의 수를 줄일 수 있지만, 그럼에도 가능한 전자 배치는 여전히 매우 많습니다.
그런데 전자 배치의 수가 많다는 것만이 문제는 아닙니다. 일반적으로 분자의 전자 상태는 하나의 배치만으로 충분히 설명되지 않기 때문입니다. 양자역학에서는 여러 전자 배치가 함께 기여하는 ‘중첩 상태’로 이를 표현합니다. 각 배치에는 기여하는 정도를 나타내는 계수가 붙으며, 이 계수에는 크기뿐 아니라 배치 사이의 간섭을 결정하는 상대적인 위상도 담깁니다.
이를 수식으로 나타내면 다음과 같습니다.
여기서 \(x\)는 ‘1100’과 같이 각 스핀 오비탈의 점유 여부를 나타내는 전자 배치이고, \(|x\rangle\)는그배치에 대응하는 상태입니다. \(|\Psi\rangle\)는이들이모여이루는전체전자상태를뜻하며, \(c_x\)는 각 배치의 계수입니다. 계수는 일반적으로 복소수이고, 그 크기의 제곱 \(|c_x|^2\)은 해당 배치를 측정할 확률을 나타냅니다. 따라서 오른쪽 조건은 모든 배치의 측정 확률을 더하면 1이 되도록 상태를 맞추는 ‘정규화’를 뜻합니다.
문제는 이러한 계수를 얼마나 많이 다루어야 하는가에 있습니다. 앞서 살펴본 스핀 오비탈 100개와 전자 50개의 예시에서는 약 \(10^{29}\)개의 배치가 가능합니다. 모든 배치의 복소수 계수를 각각 16바이트로 저장한다고 가정하면, 전자 상태 하나를 표현하는 데에만 약 \(1.6\times10^{30}\)바이트의 저장 공간이 필요합니다. 이는 전 세계에 설치된 데이터 저장장치의 총용량을 모두 합친 것보다도 약 1억 배 이상 큰 규모입니다. 비교적 작은 분자를 나타내는 예시적인 계산 공간조차, 모든 계수를 그대로 저장하기에는 너무나 큰 셈입니다.
그렇다면 이처럼 많은 전자 배치를 반드시 모두 다루어야 할까요? 실제로 어떤 배치는 전자 상태에 크게 기여하지만, 다른 배치는 거의 기여하지 않을 수 있습니다. 만약 중요한 배치들만으로 원래 상태를 충분히 잘 표현할 수 있다면, 계산에 필요한 공간을 크게 줄일 수 있을 것입니다.
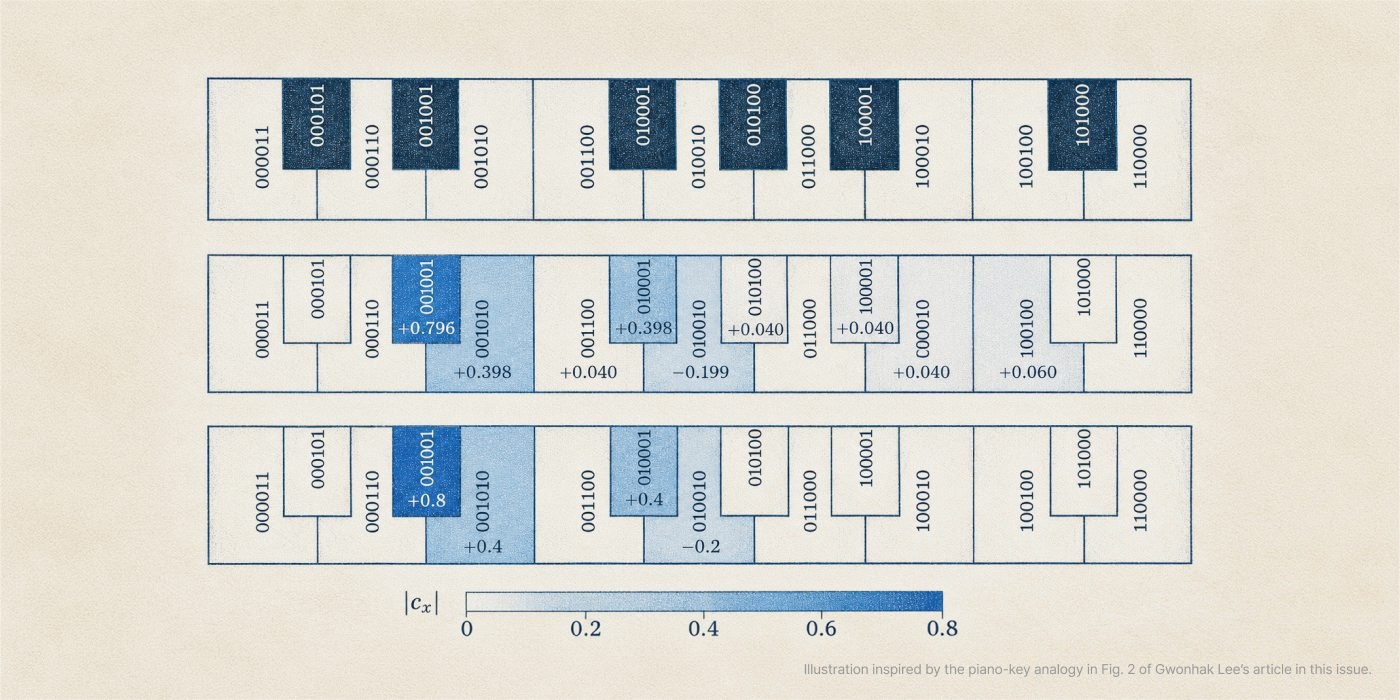
이를 이해하기 위해 이번에는 전자 배치를 피아노 건반에 비유해 보겠습니다. 전자 수를 두 개로 유지하고 스핀 오비탈을 여섯 개로 늘리면, 가능한 전자 배치는 \(\binom{6}{2}=15\)가지입니다. 이 15가지 배치를 각각 서로 다른 건반에 대응시키겠습니다. 여기서 건반 하나는 전자 한 개나 오비탈 하나가 아니라, 전자 배치 하나를 뜻합니다. 예를 들어 ‘001001’과 ‘001010’은 서로 다른 두 건반에 해당합니다.
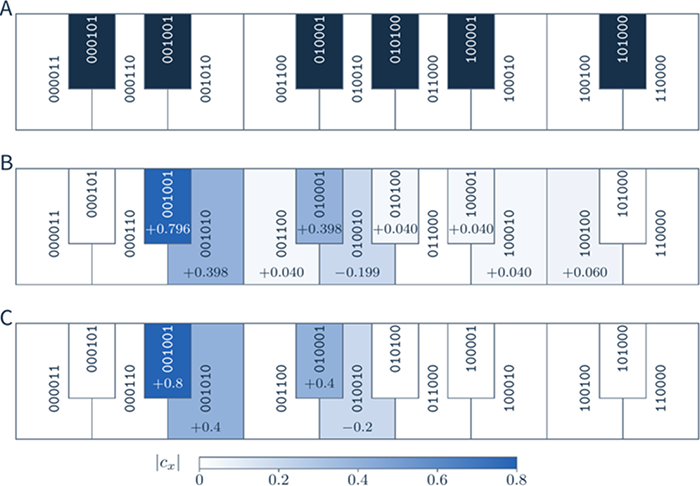
그림 2: 전자 배치와 건반의 대응. (A) 스핀 오비탈 여섯 개에 전자 두 개를 놓는 15가지 배치. (B) 네 배치가 크게, 다섯 배치가 작게 기여하는 정규화된 예시 상태 \(|\Psi\rangle\). (C) 주요 네 배치만 남겨 정규화한 상태 \(|\Psi_4\rangle = 0.8|001001\rangle + 0.4|001010\rangle + 0.4|010001\rangle - 0.2|010010\rangle\). B와 C에서는 계수가 0인 건반을 흰색으로 표시하며, 가로 범례는 계수 절댓값에 따른 색을 나타낸다. 이 실수 계수 예에서 +와 −는 상대적인 위상을 나타내며, 마이너스는 음량이 음수라는 뜻이 아니라 양의 계수를 가진 성분들과 위상이 반대라는 뜻이다.
그림 A는 15개의 건반에 가능한 전자 배치를 하나씩 대응시킨 모습입니다. 그림 B에서는 그중 아홉 배치가 기여하는 중첩 상태를, 여러 건반의 음이 함께 만드는 화음에 비유했습니다. 이때 파란색이 진할수록 해당 배치의 계수 크기가 크다는 뜻입니다.
그런데 모든 건반이 같은 크기로 울리는 것은 아닙니다. 네 배치의 계수 크기는 약 0.796, 0.398, 0.398, 0.199로 비교적 크지만, 나머지 다섯 배치의 계수 크기는 약 0.060 또는 0.040에 불과합니다. 마치 여러 음이 함께 만드는 화음에서 일부 음은 크게, 나머지는 작게 울리는 모습과 비슷합니다.
그렇다면 작은 성분들을 생략하고 주요한 음들만 남겨도 원래 화음을 충분히 잘 표현할 수 있을까요? 그림 C는 B에서 주요 네 배치만 남긴 뒤, 계수 크기의 제곱 합이 다시 1이 되도록 정규화한 상태입니다. 이 예시에서는 주요 네 배치가 원래 상태의 전체 측정 확률 중 약 99%를 차지합니다. 즉, 나머지 다섯 배치를 생략하더라도 원래 상태의 대부분을 유지할 수 있습니다.
두 전자 상태가 얼마나 비슷한지는 ‘겹침의 제곱’으로 나타낼 수 있습니다.
여기서 \(|\Psi\rangle\)는 그림 B의 원래 상태이고, \(|\Psi_4\rangle\)는 그림 C의 주요 네 배치만으로 만든 상태입니다. 겹침의 제곱은 두 상태가 같을 때 1이 되며, 이 예시에서는 약 0.99입니다. 따라서 15개 배치 중 네 개만 사용해도 원래 전자 상태를 상당히 잘 근사할 수 있다는 뜻입니다.
이 건반 비유를 앞서 살펴본 스핀 오비탈 100개·전자 50개인 경우에 적용하면, 약 \(10^{29}\)개의 건반이 필요한 셈입니다. 앞서 살펴본 바닥상태 에너지를 구하려면, 이 배치들을 바닥상태를 이루는 비중과 위상으로 조합해야 합니다. 즉, 주어진 원자핵 배치에서 전자의 에너지가 가장 낮아지도록 각 배치의 계수를 정하는 것이 목표입니다.
물론 이 예시는 중요한 배치를 이미 알고 있다고 가정한 경우이며, 실제 분자에서는 어떤 배치가 얼마나 중요한지 처음부터 알 수 없습니다. 또한 두 상태가 비슷하다고 해서 계산한 에너지까지 반드시 비슷한 것은 아닙니다. 따라서 중요한 배치를 찾는 것과 더불어, 그 배치들을 어떻게 조합해야 에너지가 가장 낮아지는지 계산하는 과정이 필요합니다.
이때 에너지를 결정하는 수학적 대상이 바로 분자의 ‘해밀토니안(Hamiltonian)’ \(H\)입니다. 해밀토니안은 전자의 운동에너지, 원자핵과 전자 사이의 인력, 전자 사이의 반발 등 에너지를 결정하는 요소들을 담고 있습니다. 이를 전자 배치들을 기준으로 표현하면 각 배치의 에너지와 서로 다른 배치 사이의 연결을 나타내는 행렬이 됩니다.
이 행렬에서 에너지와 그에 대응하는 전자 상태를 찾는 문제는 다음과 같이 씁니다.
이는 선형대수에서 말하는 고윳값·고유벡터 문제이며, 이를 푸는 계산을 ‘대각화(diagonalization)’라고 합니다. 고윳값 \(E\)는 에너지를, 고유벡터 \(|\Psi\rangle\)는 그 에너지를 갖는 전자 배치들의 조합을 알려 줍니다. 따라서 가장 작은 고윳값과 그에 대응하는 상태를 구하면, 주어진 계산 공간에서의 바닥상태 에너지와 전자 상태를 얻을 수 있습니다.
가능한 전자 배치를 모두 고려하여 이 문제를 푸는 ‘정확 대각화(Exact Diagonalization)’는 계산 공간이 커질수록 매우 어려워집니다. 그러나 앞의 건반 예시처럼 중요한 배치 몇 개만으로도 원래 상태를 잘 표현할 수 있다면 어떨까요? 모든 배치를 포함하는 거대한 행렬 대신, 선택된 배치들로 이루어진 작은 행렬에서 대각화를 수행하는 것이 ‘부분공간 대각화’입니다. 예를 들어 앞의 15가지 배치 중 주요 네 배치를 선택하면, \(15\times15\) 해밀토니안에서 그 네 배치에 해당하는 행과 열이 만나는 원소들로 \(4\times4\) 행렬을 구성할 수 있습니다(그림 3). 이 작은 행렬을 대각화하면, 선택한 네 배치를 어떻게 조합해야 에너지가 가장 낮아지는지 구할 수 있습니다. 이를 통해 계산 부담을 크게 줄이면서도 바닥상태 에너지를 잘 근사할 가능성이 있습니다.
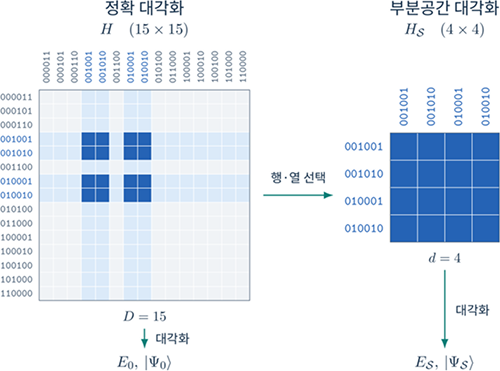
그림 3: 전체 공간의 정확 대각화와 선택한 부분공간의 대각화. 왼쪽은 스핀 오비탈 여섯 개에 전자 두 개를 놓는 15가지 배치를 모두 포함한 \(15\times15\) 해밀토니안 \(H\)이다. 각 행과 열은 전자 배치 하나에 대응하며, 옅은 파란색 띠는 건반 예시의 주요 네 배치에 해당하는 행과 열을 나타낸다. 그 교차점의 진한 파란색 원소 16개를 같은 순서로 모으면 오른쪽의 \(4\times4\) 행렬 \(H_{\mathcal S}\)가 된다. 색은 원소의 선택 여부를 나타내며, 값의 크기를 뜻하지 않는다. 각 행렬을 대각화하여 가장 낮은 에너지와 그 상태를 구하면, 왼쪽에서는 전체 공간의 \(E_0, |\Psi_0\rangle\)를, 오른쪽에서는 선택한 공간의 \(E_{\mathcal S}, |\Psi_{\mathcal S}\rangle\)를 얻는다. 실제 부분공간 계산에서는 전체 행렬을 먼저 만들 필요 없이 선택한 배치 사이의 원소만 계산할 수 있다.
결국 핵심은 수많은 전자 배치 중에서 어떤 배치를 선택해야 하는가입니다. 앞의 건반 예시에서는 주요 네 배치를 미리 알고 있었지만, 실제 분자에서는 중요한 배치를 찾아내는 것부터 쉽지 않습니다.
그렇다면 양자컴퓨터의 측정 결과를 활용하여 이러한 배치들을 찾아낼 수 있을까요? 다음 장에서는 양자컴퓨터로부터 얻은 전자 배치를 바탕으로 작은 계산 공간을 구성하고, 그 안에서 고전적인 대각화를 수행하는 SQD(Sample-based Quantum Diagonalization)를 살펴보겠습니다.
SQD: 후보는 양자컴퓨터, 조합은 고전컴퓨터
앞서 살펴본 것처럼, 전자 상태를 잘 표현하는 데 반드시 모든 전자 배치가 필요한 것은 아닙니다. 중요한 배치들을 선택하고, 그 안에서 에너지가 가장 낮아지는 조합을 찾을 수 있다면 계산해야 할 공간을 크게 줄일 수 있습니다.
SQD(Sample-based Quantum Diagonalization, 샘플 기반 양자 대각화)는 이 과정에서 양자컴퓨터와 고전컴퓨터의 역할을 나누는 방법입니다. 양자컴퓨터는 유용한 전자 배치의 후보를 얻는 데 사용하고, 고전컴퓨터는 선택된 배치들을 조합하여 에너지를 계산합니다. 그 과정을 차례로 살펴보겠습니다.
첫째, 양자컴퓨터가 전자 배치의 후보를 모읍니다.
먼저 분자의 전자 상태를 근사하도록 설계한 양자 회로를 실행합니다. 앞서 설명한 것처럼, 전자 배치를 0 과 1 의 문자열로 표현할 수 있는데, 스핀 오비탈의 점유 여부를 큐비트에 직접 대응시키면 양자컴퓨터의 측정 결과를 전자 배치로 해석할 수 있습니다.
여기서 중요한 점은 한 번의 측정으로는 전자 배치 하나만 얻는다는 것입니다. 따라서 같은 상태를 여러 번 준비하고 측정하여 다양한 배치를 모아야 합니다. 이렇게 반복적인 측정으로 전자 배치의 표본을 얻는 과정을 ’샘플링(sampling)’이라고 합니다.
어떤 배치가 얼마나 자주 측정되는지는 앞에서 살펴본 중첩 상태의 계수와 관련이 있습니다. 양자컴퓨터가 준비한 상태에서 배치 \(x\)를 측정할 확률은 다음과 같습니다.
예를 들어 앞의 건반 그림 C에 해당하는 상태를 준비했다고 가정해 봅시다. 이 상태에서 ’001001’의 계수 크기는 0.8이므로 측정 확률은 \(0.8^2=0.64\), 즉 64%입니다. 나머지 세 배치의 확률은 각각 16%, 16%, 4%입니다. 따라서 같은 상태를 반복해서 측정하면 계수의 크기가 큰 배치가 더 자주 나타나는 경향이 있습니다. 반면 계수가 작은 배치는 드물게 나타나거나, 측정 횟수가 충분하지 않으면 아예 관측되지 않을 수도 있습니다.
그런데 실제 분자에서는 어떤 전자 배치가 중요한지, 각 배치가 얼마나 기여하는지 미리 알기 어려울 뿐더러, 가능한 배치가 매우 많기 때문에 이들을 모두 계산하고 비교하기도 어렵습니다. 여기서 양자컴퓨터가 도움을 줄 수 있습니다. 양자컴퓨터에 분자의 바닥상태를 어느 정도 반영하는 상태를 준비할 수 있다면, 모든 배치의 계수를 직접 계산하지 않고도 반복 측정을 통해 유용한 배치 후보들을 얻을 수 있기 때문입니다. 즉, 양자컴퓨터는 수많은 배치 중 어디에 주목해야 할지 알려주는 역할을 합니다. 다만 측정 결과만으로 각 배치의 계수에 담긴 부호나 상대적인 위상을 알아낼 수는 없습니다. 따라서 SQD 에서는 양자컴퓨터로 배치 후보를 모으고, 고전컴퓨터가 이들을 조합하여 에너지가 가장 낮아지는 상태를 계산합니다.
둘째, 고전컴퓨터가 잡음이 섞인 후보를 처리합니다.
실제 양자컴퓨터에서는 연산이나 측정 과정에서 오류가 발생할 수 있습니다. 예를 들어 전자가 두 개여야 하는데 ’1110’처럼 전자 세 개에 해당하는 결과가 측정될 수도 있습니다. 이러한 결과는 전자 수가 보존되어야 한다는 물리적 조건에 어긋납니다. 단순히 잘못된 결과를 버릴 수도 있지만, 그러면 그 안에 남아 있는 유용한 정보까지 잃게 됩니다.
SQD 에서는 이를 보완하기 위해 ’배치 복원(configuration recovery)’이라는 방법을 사용합니다. 전자 수와 같은 물리적 조건과 각 스핀 오비탈이 점유될 가능성에 대한 정보를 활용하여, 조건에 맞지 않는 측정 결과의 일부 비트를 확률적으로 수정하는 것입니다. 물론 이렇게 복원한 배치가 오류가 발생하기 전의 원래 배치와 같다는 보장은 없습니다. 또한, 전자 수를 보존하면서 발생하는 오류도 있기 때문에, 배치 복원으로 모든 오류를 제거할 수도 없습니다. 그럼에도 오류가 포함된 측정 결과를 일부 활용함으로써, 다음 계산에 사용할 배치 후보들을 확보할 수 있습니다.
셋째, 고전컴퓨터가 후보들의 가장 낮은 에너지 조합을 찾습니다.
이제 후보 배치들이 준비되었다면, 앞 절에서 소개한 해밀토니안과 대각화를 활용하여 에너지가 가장 낮아지는 배치들의 조합을 찾을 차례입니다. 선택한 배치들의 집합을 \(\mathcal S\)라고 하면, 이 배치들로 구성한 전자 상태는 다음과 같이 표현할 수 있습니다.
앞에서 사용했던 계수 \(c_x\) 대신 \(a_x\)를 사용한 이유는 고전컴퓨터가 각 배치의 계수를 새롭게 계산하기 때문입니다. 고전컴퓨터는 선택한 배치들 사이에서 해밀토니안의 행렬을 구성하고, 이를 대각화하여 에너지가 가장 낮아지는 계수의 조합을 구합니다. 이를 수식으로 나타내면 다음과 같습니다.
첫 번째 식은 선택된 배치들을 기준으로 해밀토니안 행렬을 만드는 과정입니다. 이 행렬에는 각 배치의 에너지뿐 아니라 서로 다른 배치 사이의 연결 효과도 포함됩니다. 두 번째 식은 이렇게 만든 행렬을 대각화하는 과정입니다. 가장 작은 고윳값 \(E_{\mathcal S}\)는 선택된 공간에서 얻을 수 있는 최저 에너지이고, 대응하는 고유벡터 \(\mathbf{a}\)는 그 에너지를 갖는 배치들의 계수를 알려 줍니다.
앞서 전체 전자 배치의 수를 \(D\)라고 했습니다. SQD에서는 이 모든 배치를 사용하는 대신, 양자컴퓨터의 측정 결과를 바탕으로 일부 배치만 선택합니다. 따라서 선택한 배치의 수 \(d\)는 전체 배치의 수 \(D\)보다 훨씬 작게 설정할 수 있습니다. 그 결과 전체 \(D\times D\) 행렬 대신 \(d\times d\) 크기의 행렬에서 대각화를 수행하여 계산 부담을 크게 줄일 수 있습니다.
실제 SQD에서는 후보 배치들을 여러 작은 집합으로 나누어 각각 대각화하기도 합니다. 또한 대각화에서 얻은 전자 상태로부터 각 오비탈의 평균 점유 정보를 계산하고, 이를 다시 배치 복원에 활용할 수 있습니다. 배치 복원과 대각화를 반복하면서 에너지 추정값을 개선하는 것입니다.
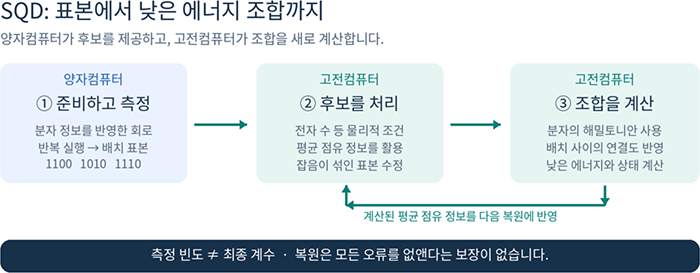
그림 4: SQD의 역할 분담. 양자컴퓨터가 측정을 통해 전자 배치 후보를 제공하면, 고전컴퓨터가 배치 복원과 부분공간 대각화를 수행한다. 대각화에서 얻은 평균 점유 정보를 배치 복원에 다시 활용하는 반복 과정도 포함된다. 후보 선택과 표본 분할 등의 구현 세부는 생략한 개념도이다.
물론 배치의 수를 줄이는 것만으로 정확한 결과가 보장되지는 않습니다. 바닥상태를 구성하는 중요한 배치들이 선택한 공간에 충분히 포함되어 있어야 하기 때문입니다. 필요한 배치를 놓쳤다면 나머지 배치의 계수를 조정하는 것만으로는 정확한 결과를 얻기 어렵습니다. 결국 SQD 의 성능은 얼마나 적은 수의 배치로 바닥상태를 잘 표현할 수 있는지, 중요한 배치들을 얼마나 효과적으로 찾아내는지, 그리고 잡음이 포함된 측정 결과를 어떻게 처리하고 선택된 공간에서 얼마나 효율적으로 계산하는지에 달려 있습니다.
작은 계산들을 연결해 단백질로
SQD를 활용하면 중요한 전자 배치들만 선택하여 계산할 수 있습니다. 그러나 이것만으로 아직 큰 단백질의 전자구조 문제를 해결하기는 어렵습니다. 단백질과 리간드, 주변 물 분자까지 포함하면 다루어야 할 전자와 오비탈이 여전히 너무 많기 때문입니다. 현재의 양자컴퓨터로는 이 모든 정보를 하나의 양자 회로에 담는 것은 현실적으로 어렵습니다.
이를 해결하기 위해 IBM 공동연구진은 ‘임베디드 파동함수(Embedded Wavefunction, EWF)’라는 임베딩 방법을 사용했습니다. 임베딩은 큰 분자에서 자세히 계산할 부분을 정하고, 나머지 부분이 미치는 영향을 함께 고려하는 방법입니다. 각 부분의 전자 상태는 주변 환경의 영향을 받기 때문에, 이러한 관계를 적절히 반영해야 합니다. EWF에서는 원자를 중심으로 작은 계산 영역을 구성하되, 주변과의 양자역학적 상관관계를 나타내는 오비탈도 함께 포함합니다. 이렇게 만들어진 각각의 부분 문제를 계산한 뒤, 그 결과를 정해진 방법으로 결합하여 전체 계의 에너지를 구합니다. 각각의 부분 문제들 중 규모가 큰 부분은 SQD를 활용하고, 규모가 작거나 계산 조건이 다른 일부 문제에는 고전적인 전자구조 계산 방법도 사용할 수 있습니다. 이처럼 큰 문제를 나누고 각 부분에 적절한 계산 방법을 적용하면, 양자컴퓨터가 직접 다룰 수 있는 범위보다 훨씬 큰 분자도 계산할 수 있습니다.
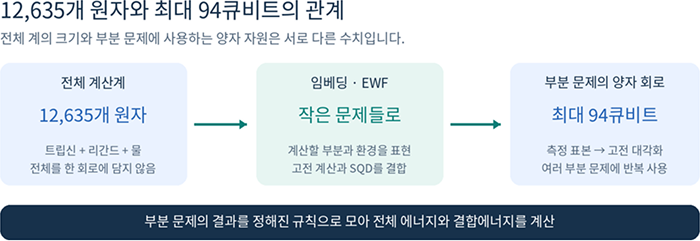
그림 5: 전체 계산계와 부분 문제의 규모. 12,635개 원자는 단백질, 리간드, 주변 물 분자를 포함한 전체 계의 크기이며, 최대 94 큐비트는 그중 하나의 부분 문제에 사용된 양자 회로의 규모이다.
이것이 이번 연구에서 12,635개 원자와 최대 94큐비트라는 숫자가 함께 등장하는 이유입니다. 원자 수는 전체 계산 대상의 크기를 나타내지만, 큐비트 수는 그중 일부를 계산하는 데 필요한 자원입니다. 두 양자컴퓨터의 큐비트를 합쳐 하나의 거대한 양자 상태를 만든 것은 아닙니다.
IBM 공동연구진은 무엇을 계산했을까?
연구진은 이러한 방법을 실제 단백질과 리간드의 결합에 적용했습니다. 계산 대상은 두 가지입니다.
첫 번째는 소화 효소인 트립신(trypsin)과 그에 결합하는 벤즈아미딘(benzamidine)입니다. 주변 물 분자까지 포함한 전체 계산계는 12,635개 원자로 이루어져 있습니다.
두 번째는 세균의 세포벽을 분해하는 효소인 T4 라이소자임(T4 lysozyme)과 n-부틸벤젠(n-butylbenzene)입니다. 이 계는 주변 물을 포함해 11,608개 원자로 구성됩니다.
두 계는 서로 다른 분자 간 상호작용을 대표하는 연구 대상입니다. 트립신과 벤즈아미딘의 결합에는 전하 사이의 정전기적 상호작용이 중요하고, T4 라이소자임과 n-부틸벤젠의 결합에서는 비극성 분자 사이의 상호작용이 중요한 역할을 합니다.
연구진의 목표는 앞서 소개한 결합에너지, 즉 단백질과 리간드가 결합한 상태와 분리된 상태 사이의 에너지 차이를 계산하는 것이었습니다. 이를 위해 전체 계를 여러 작은 전자구조 문제로 나누고, 양자컴퓨터와 고전 슈퍼컴퓨터를 함께 활용했습니다. 각 부분의 계산 결과를 모아 전체 에너지를 구한 뒤, 결합 전후의 에너지 차이를 계산했습니다.
이 과정에는 SQD를 개선한 ‘TrimSQD’라는 방법도 사용했습니다. TrimSQD는 고전적인대각화 결과를 바탕으로 기여도가 높은 전자 배치를 추려 다음 계산에 활용합니다. 특히 여러 부분공간에서 얻은 중요한 배치들을 다시 모아 평가함으로써, 처음 측정에서 자주 나타난 배치에만 의존하지 않고 더 유용한 조합을 찾도록 설계되었습니다.
그렇다면 실제 계산 결과는 어땠을까요? 연구진은 T4 라이소자임과 n-부틸벤젠의 결합에너지를 계산하면서, 결합 부위에 더 정밀한 기저함수를 사용하고 임베딩의 정확도를 높였습니다. 그 결과 EWF와 TrimSQD를 결합한 방법으로 약 \(-21.07\,\mathrm{kcal/mol}\)의 결합에너지를 얻었습니다. 같은 계산 조건에서 고전적인 CCSD 방법으로 얻은 값은 약 \(-17.31\,\mathrm{kcal/mol}\)였습니다.
물론 이 수치가 실제 실험에서 측정되는 결합 친화도와 곧바로 일치한다는 뜻은 아닙니다. 다만 이번 연구는 큰 단백질–리간드 계에서 양자–고전 협력 계산으로 결합에너지를 구하고, 이를 기존의 고전적 전자구조 계산 결과와 비교했다는 데 의미가 있습니다.
계산 규모 한눈에 보기
2026년 9월 5일 개정 원고에 기재된 연구 전체의 자원 사용량입니다.
- 양자 장치: IBM의 156 큐비트 프로세서 두 대, 회로 하나에 최대 94큐비트 사용
- 양자 회로: 총 21,006개, 측정 결과 약 30억 개
- 양자 장치 사용 시간: 합계 239시간 이상
- 고전 계산: Fugaku, Miyabi-G, ROQUO 활용
이 숫자들은 연구에서 수행한 여러 계산을 합친 결과입니다. 따라서 239시간은 하나의 양자 회로를 실행한 시간이나 전체 연구를 시작해서 끝낼 때까지의 경과 시간을 의미하지 않습니다. 실제로 연구진은 별도의 자동화된 계산 실험에서 T4 라이소자임과 리간드가 결합한 계의 에너지를 구하는 과정을 약 62.4시간에 수행했다고 보고했습니다. 여기에는 양자컴퓨터의 측정뿐 아니라 부분 문제의 생성, 고전적인 대각화, 전체 에너지의 재구성 등이 포함됩니다.
이번 성과의 의미와 다음 질문
지금까지 양자컴퓨터를 이용한 전자구조 계산은 비교적 작은 분자나 제한된 계산 문제를 중심으로 발전해 왔습니다. 이번 연구는 임베딩을 통해 그 적용 범위를 1만 개 이상의 원자로 이루어진 단백질–리간드 계까지 확장하고, 양자컴퓨터와 고전 슈퍼컴퓨터를 연결하여 실제 결합에너지 계산을 수행했다는 데 의미가 있습니다. 또한 연구진은 양자 회로의 실행부터 측정 결과의 처리, 부분공간 대각화, 전체 에너지 계산까지 이어지는 과정을 자동화했습니다. 이는 단순히 한 번의 계산에 성공하는 것을 넘어, 양자컴퓨터를 대규모 과학 계산에 반복적으로 활용할 수 있는 기반을 마련했다는 점에서도 중요합니다.
그렇다면 이번 연구가 고전컴퓨터보다 양자컴퓨터가 우수하다는 사실을 입증한 것일까요? 아직 그렇지는 않습니다. 연구진도 이번 결과를 ‘양자 이득(quantum advantage)’의 근거로 주장하지 않는다고 명시했습니다.
양자 이득이란 특정 계산 문제에서 양자컴퓨터를 활용하는 방법이 고전컴퓨터만 사용하는 방법보다 더 나은 성능을 보이는 것을 뜻합니다. 예를 들어 같은 정확도의 결과를 얻는 데 필요한 시간이나 계산 자원을 줄일 수 있다면 양자 이득의 근거가 될 수 있습니다.
이번 연구에서도 SQD 를 활용한 부분 문제의 계산 성능을 밀도행렬 재규격화군(Density Matrix Renormalization Group, DMRG)과 같은 고전적 전자구조 계산 방법과 비교했습니다. 일부 비교에서는 SQD 기반 방법이 높은 정확도를 더 짧은 시간에 달성했지만, 고전 알고리즘의 최적화 수준과 계산 자원의 차이를 고려하면 아직 양자 이득을 입증했다고 보기는 어렵습니다.
IBM은 양자 이득을 달성하기 위한 핵심 접근법으로 ‘양자 중심 슈퍼컴퓨팅(Quantum-Centric Supercomputing, QCSC)’을 제시하고 있습니다. QCSC는 양자컴퓨터와 고전 슈퍼컴퓨터를 하나의 계산 체계로 통합하여, 각 장치가 잘 수행할 수 있는 작업을 나누어 처리하는 방식입니다. 양자컴퓨터가 고전컴퓨터를 대체하는 것이 아니라, 서로 협력하여 기존 방법보다 복잡한 문제를 더 효율적으로 해결하는 것을 목표로 합니다.
이번 연구는 이러한 QCSC의 접근법을 실제 대규모 생체분자 계산에 적용한 사례라는 점에서 의미가 있습니다. 특히 일부 전자구조 문제에서 SQD 기반 방법이 DMRG에 근접한 정확도를 더 짧은 시간에 달성했다는 점은 주목할 만합니다. 아직 최적화된 고전 알고리즘과의 공정한 비교를 통한 검증이 필요하지만, 이러한 성과는 양자–고전 협력 계산이 실질적인 양자 이득에 가까워지고 있음을 보여줍니다.
앞으로 양자 하드웨어와 SQD 알고리즘이 더욱 발전한다면, 가까운 미래에 QCSC를 통한 양자 이득이 실증될 것으로 기대됩니다. 이는 양자컴퓨터가 실제 과학 계산에서 고전컴퓨터만으로는 얻기 어려운 계산상의 이점을 제공할 수 있음을 입증하는 중요한 이정표가 될 것입니다. 나아가 신약 개발과 신소재 설계 등 복잡한 분자 계산이 필요한 분야에서 양자컴퓨터의 활용을 본격적으로 확대하는 계기가 될 것입니다.
더 읽어 보기
- 1Kenneth M. Merz, Jr. et al. Crossing the 12,000-atom barrier with heterogeneous quantum-classical supercomputing: quantum chemistry of protein-ligand complexes. arXiv:2605.01138v2, 2026. URL https://arxiv.org/abs/2605.01138v2. Version 2, September 5, 2026; source version for the resource counts in this manuscript.
- 2IBM Quantum. Researchers use quantum-centric supercomputing to simulate 12,635-atom protein complex. IBM Quantum Blog, 2026. URL https://www.ibm.com/quantum/blog/cleveland-clinic-riken-chemistry. May 5, 2026; initial announcement, predating the revised preprint.
- 3Javier Robledo-Moreno et al. Chemistry beyond the scale of exact diagonalization on a quantum-centric supercomputer. Science Advances, 11 (25): eadu9991, 2025. doi: 10.1126/sciadv.adu9991. URL https://arxiv.org/abs/2405.05068.
- 4IBM Quantum. Sample-based quantum diagonalization. IBM Quantum Learning, n.d.. URL https://quantum.cloud.ibm.com/learning/en/courses/quantum-diagonalization-algorithms/sqd-overview. Educational resource; consulted for the original draft, September 2026.
- 5IBM Quantum. Sample-based quantum diagonalization (SQD). IBM Quantum Documentation, n.d.. URL https://quantum.cloud.ibm.com/docs/en/addons/qiskit-addon-sqd. Software documentation; consulted for the original draft, September 2026.
- 6Akhil Shajan et al. Towards quantum-centric simulations of extended molecules: sample-based quantum diagonalization enhanced with density matrix embedding theory. arXiv:2411.09861, 2024. URL https://arxiv.org/abs/2411.09861. Uses DMET embedding, distinct from the EWF approach in the protein-complex study.


관련 논문 보기
 퀀텀웨이브 정기출판물
뉴스레터 구독
파동의교차,지식의융합 양자세계의 최신소식을 받아보세요.
퀀텀웨이브에서 제공하는 콘텐츠

주목할 만한 최신 연구성과
양자물리학 분야의 혁신적 연구 결과를 쉽게 풀어서 소개하고 해설합니다

양자 세부분야 리뷰
양자컴퓨팅, 양자통신, 양자센서 등 각 분야별 심화 리뷰와 동향 분석

국내 연구실 연구 동향
국내 대학 및 연구기관의 양자 관련 연구 소식과 성과를 전해드립니다
주목할 만한 최신 연구
더 많은 내용보기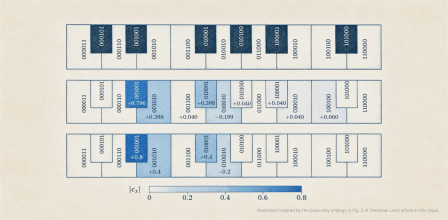
열린 강의실
샘플 기반 양자 대각화(SQD)의 원리와 응용 : 전자구조 계산의 기초에서 단백질–리간드 복합체까지
분자의 구조와 결합을 이해하려면, 그 안의 전자들이 어떤 상태를 이루고 얼마만큼의 에너지를 갖는지 알아야 합니다. 양자화학에서는 이를 양자역학으로 설명하고 계산하지만, 전자 상태를 표현하는 데 필요한 배치의 수가 급격히 늘어나면서 정밀한 계산이 어려워집니다. 따라서 중요한 정보를 유지하면서 계산 규모를 줄이는 것이 핵심 과제이며, 양자컴퓨터와 고전컴퓨터가 계산의 역할을 나누는 접근이 그 해결 방법으로 연구되고 있습니다. 샘플 기반 양자 대각화(Sample-based Quantum Diagonalization, SQD)는 이러한 협력을 활용하는 알고리즘입니다. 양자컴퓨터는 측정을 통해 전자 배치의 후보를 제공하고, 고전컴퓨터는 그 후보들을 조합해 에너지가 가장 낮은 상태를 구합니다. 이 글에서는 전자구조 계산의 기초에서 출발해 SQD의 원리와 두 컴퓨터의 역할을 살펴봅니다. 이어서 IBM·클리블랜드 클리닉·일본 이화학연구소(RIKEN)가 수행한 12,635개 원자를 포함하는 단백질–리간드 계의 계산 사례를 통해, 큰 분자에 이 방법을 적용하는 과정과 그 의미를 알아보겠습니다. [1, 2]
양자 큐레이션
실용적인 양자 우위를 위한 구글의 시도
오류 정정된 큰 양자 컴퓨터가 마침내 개발되면 소인수 분해 외에 어떤 쓸모 있는 계산을 할 수 있을까? 구글 퀀텀 AI 등의 연구진이 최적화 문제를 푸는 양자 알고리즘 DQI(Decoded Quantum Interferometry)를 제안했다. DQI는 양자 간섭으로 좋은 해가 나올 확률을 키우며, 그 과정에 오류 정정 부호의 복호를 쓴다. 특정한 문제에서는 DQI의 근사비를 증명할 수 있고, 그 값은 알려진 고전 알고리즘보다 높다. 다만 더 나은 고전 알고리즘이 나올 수 있어 실제 양자 이득 여부는 아직 연구 중이다.
열린 강의실
Quantum for AI: 양자컴퓨팅은 인공지능에 어떻게 쓰일까
데이터 표현, 유사도 계산, 최적화, 확률분포의 표본추출 등 인공지능을 구성하는 여러 계산에 활용될 수 있으며, 이를 위한 다양한 양자 알고리즘과 학습모형이 연구되고 있다. 현재 연구의 대부분은 인공지능 시스템 전체를 양자컴퓨터로 구현하기보다, 특정 계산을 양자적으로 수행할 때 이점이 생기는지를 밝히는 데 집중되어 있다. 장기적으로는 데이터의 표현과 저장, 모델의 학습과 추론, 그리고 최적화와 탐색를 포함한 계산 전반을 양자컴퓨터에서 수행하는 구조도 생각할 수 있다. 그러나 이러한 전면적인 양자 구현이 원리적으로 가능하다는 것과 실제로 효율적이라는 것은 별개의 문제다. 초기 양자 기계학습은 선형 방정식을 빠르게 푸는 양자 알고리즘을 서포트 벡터 머신과 주성분분석에 적용해 큰 이론적 속도 향상을 제시했다. 그러나 이러한 결과는 대규모 데이터를 양자 상태로 빠르게 준비하고, 긴 회로를 정확하게 실행하며, 양자 상태에 담긴 결과에서 필요한 정보만 효율적으로 읽을 수 있다는 강한 조건을 요구한다. 또한 두 방법 모두 기본적으로 선형 분류와 선형 차원축소를 다루므로, 데이터에 적합한 비선형 표현을 스스로 학습하는 현대 딥러닝과는 해결하려는 문제가 다르다. 현재의 양자 장치에서 실행할 수 있는 양자 신경망과 양자 커널은 긴 회로에 대한 의존을 줄이면서 비선형 함수를 표현할 수 있다. 하지만 양자 신경망은 매개변수가 늘어날수록 기울기 계산에 필요한 회로 실행 횟수가 증가하고, 양자 커널은 데이터 수가 커질수록 유사도 계산량이 빠르게 늘어난다. 따라서 기존 딥러닝을 같은 방식으로 더 빠르게 실행하기보다는, 양자 장치가 자연스럽게 만들어 내는 확률분포와 표본을 생성 모델에 활용하는 방향이 더 적합할 수 있다. 특히 볼츠만 머신처럼 복잡한 확률분포에서 표본을 반복해서 뽑아야 하는 에너지 기반 모델은 양자 어닐링과 직접 연결될 수 있다. 어느 경우에도 데이터 입력, 반복 측정과 고전 최적화를 포함한 전체 비용을 비교해야 실제 양자 이득을 판단할 수 있다. .author_wrap .item2 { display: none; }